Почему сайт не индексируется в Яндексе: порядок проверки
Статус URL, обход, запреты и содержание: что проверить в Вебмастере.

Содержание статьи
Если сайт не индексируется в Яндексе, начните с точного URL в Яндекс Вебмастере: проверьте, известен ли адрес роботу и какая причина исключения указана. Затем получите ответ страницы, проверьте запреты, канонический адрес, внутренние ссылки и содержание. Для всего сайта и одной страницы причины различаются, поэтому записывайте результаты по нескольким типовым адресам, а не делайте вывод по одному запросу в поиске.
Как отличить проблему всего сайта от одного раздела
Составьте выборку: главная, важная услуга, категория, карточка, статья и URL, отсутствие которого заметили. Проверьте точный протокол и домен, включая вариант www, если он используется. В Яндекс Вебмастере откройте «Страницы в поиске» и список исключённых. Отдельный инструмент «Анализ индексации страницы» проверяет запреты для робота, но положительный результат там не подтверждает участие URL в поиске. Запишите дату последнего известного обхода и причину из подходящего отчёта. Ручной запрос с оператором site: может подсказать, что проверить, но не заменяет данные кабинета.
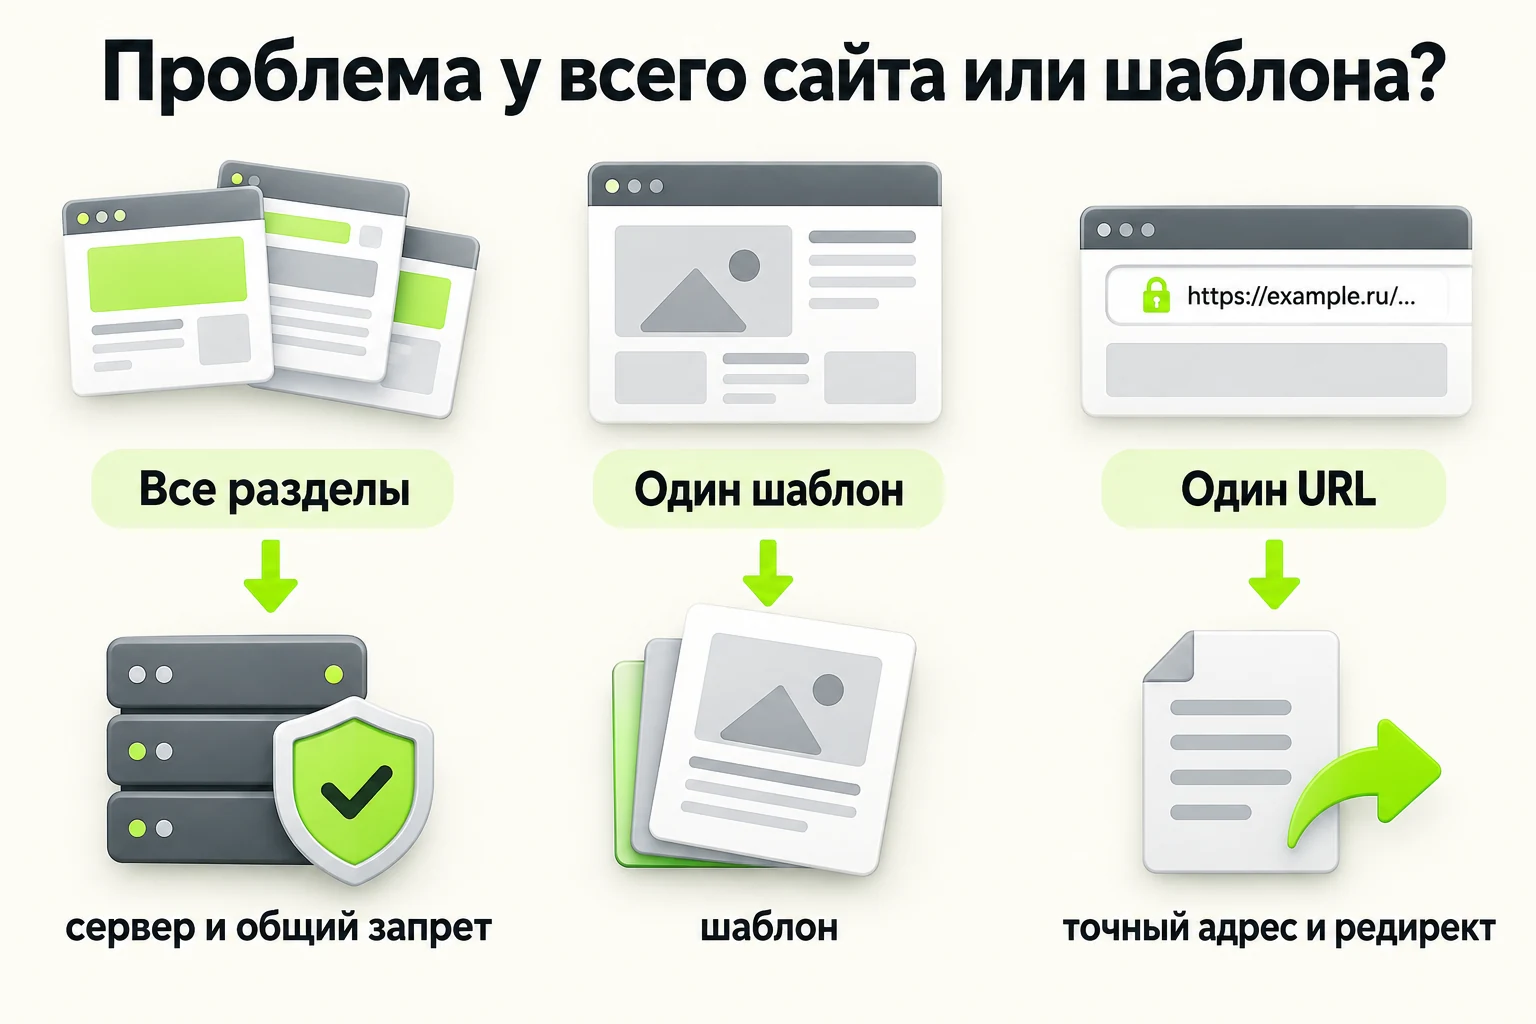
Если отсутствуют все типы страниц, ищите общий запрет, недоступность сервера, ошибку домена или ограничение сайта. Если исключены карточки одного шаблона, проверяйте шаблон и данные товаров. Если пропала одна старая страница после переноса, начните с её редиректа и нового канонического URL. Такой разбор сокращает список возможных причин до проверяемой группы.
Сверьте период наблюдения. Новая страница может ещё не быть известна роботу, тогда как ранее участвовавшая в поиске услуга исчезла после конкретного релиза. Для второй ситуации сохраните дату последнего показа или обхода и дату изменения шаблона. Не делайте вывод о «санкции всего сайта» по одному удалённому товару. Если доступа к кабинету нет, укажите это явно: ответ сервера и содержимое проверяются без него, но утверждать статус поиска по догадке нельзя.
| Наблюдение | Первая проверка | Пример доказательства |
|---|---|---|
| Нет всех основных разделов | Домен, ответ сервера, общие запреты и уведомления | Одинаковая ошибка на разных шаблонах |
| Пропали только товары | Шаблон карточки, наличие, ссылки категорий | Несколько URL с одной причиной исключения |
| Нет одной страницы | Её точный адрес, canonical, редирект и содержимое | Статус этого URL и выбранный основной адрес |
| Сводка кабинета пуста | Доступ, дата данных и свойства сайта | Недоступность отчёта отделена от состояния сайта |
Что получает робот по опубликованному адресу
Проверьте конечный HTTP-статус и цепочку переходов. Нужная опубликованная страница должна возвращать содержательный ответ 200. Ошибка 5xx, пароль, защитная заглушка или бесконечное перенаправление мешают получить материал. Страница с 404 или 410 обычно сообщает об удалении; отправлять её на переобход как новый документ бессмысленно, пока не уточнено, должна ли она существовать.
Статус 200 не завершает проверку. Посмотрите HTML и содержимое: если шаблон показывает «ничего не найдено», робот получает пустую страницу при формальном успехе. Для сайта, где текст подставляет JavaScript, сравните исходный и доступный роботу вариант. Если важный текст появляется только после выбора города или входа в аккаунт, проверьте, что доступно без такого действия.
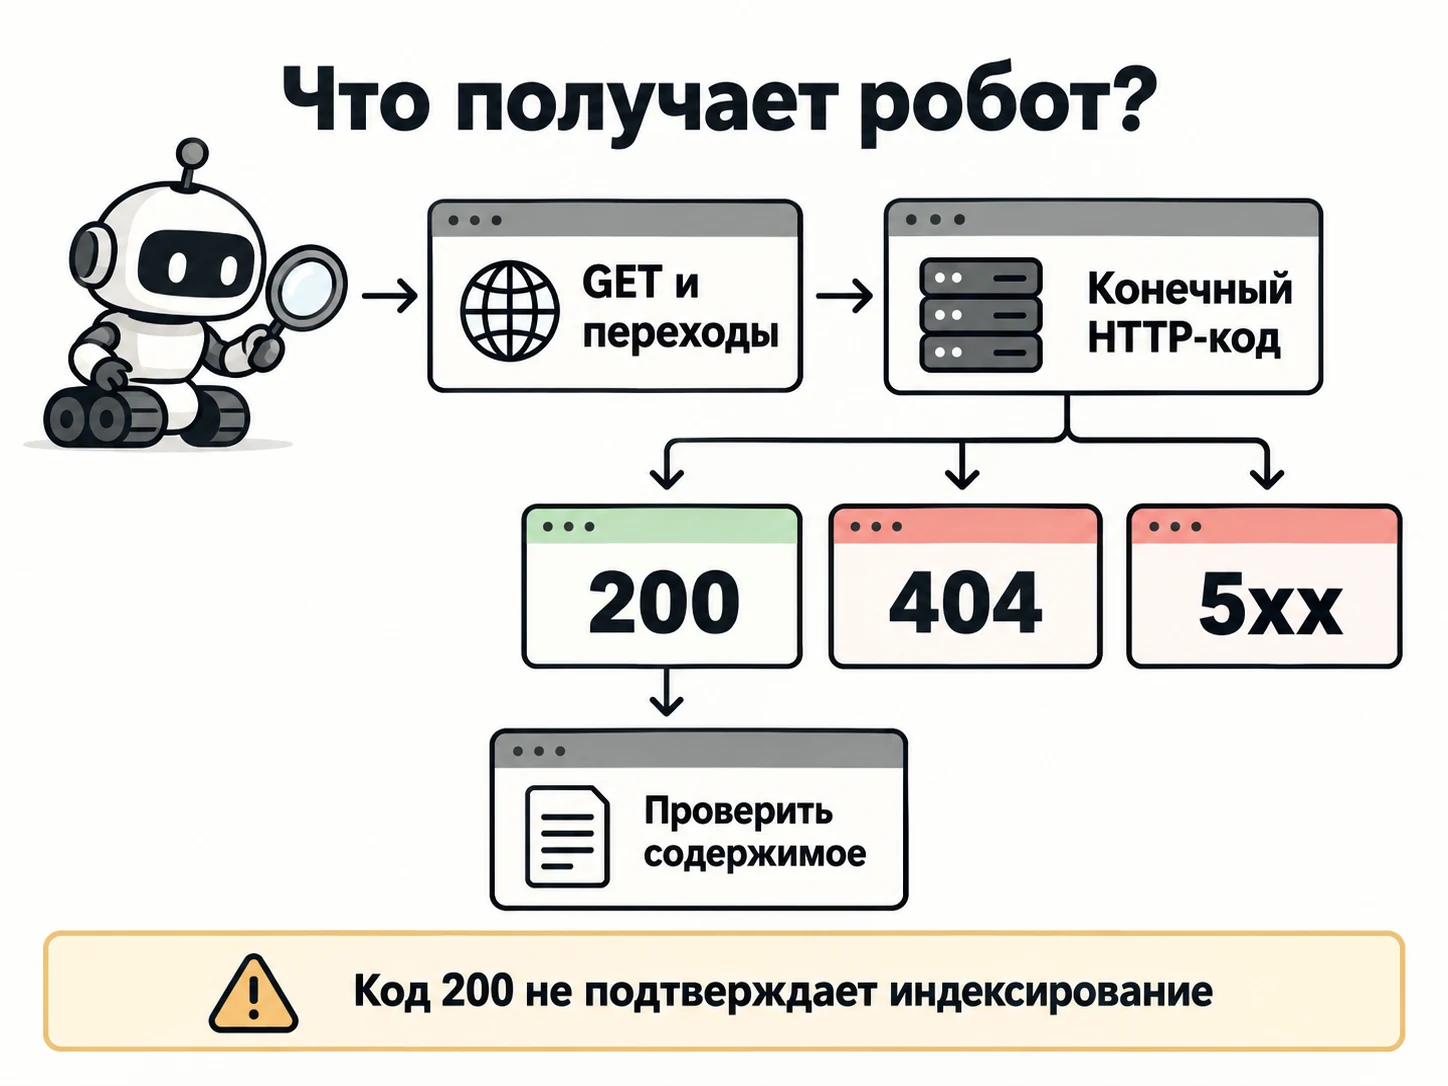
Запишите URL, время, конечный статус, основные заголовки ответа и фрагмент текста без персональных данных. При нестабильной ошибке проверьте журнал сервера и повторите запрос с разных соединений. Успешная загрузка с рабочего компьютера владельца не доказывает, что робот не получает защитный экран.
Для повторения проверки используйте обычный GET-запрос к точному URL и сохраните всю цепочку HTTP-ответов. HEAD-запрос некоторых серверов отличается от GET и не подтверждает содержимое страницы. Сравните конечный URL и видимый текст с адресом, который вы собираетесь индексировать. Если домен менялся, проверьте старую и новую версии с теми же условиями. При расхождении между браузером и инструментом Вебмастера смотрите время проверки, доступность DNS и правила защиты, а не подставляйте один ответ вместо другого.
Закрыт ли путь в robots.txt
Откройте /robots.txt именно на рабочем домене и сопоставьте путь проблемного URL с применимыми правилами для робота Яндекса. После переноса с тестового окружения может остаться общий Disallow: / или закрытый каталог услуг. Сложные шаблоны проверяйте инструментом анализа robots.txt в Вебмастере, когда он доступен. Не переносите правила другого домена по памяти.
robots.txt регулирует обход. Если нужно убрать страницу из поиска через noindex, робот должен получить документ и увидеть директиву. Закрытый обход и метатег с noindex решают разные задачи; их сочетание может помешать диагностике. Для исправления случайного запрета снимайте только правило, затронувшее нужные адреса, и проверяйте соседние служебные разделы.
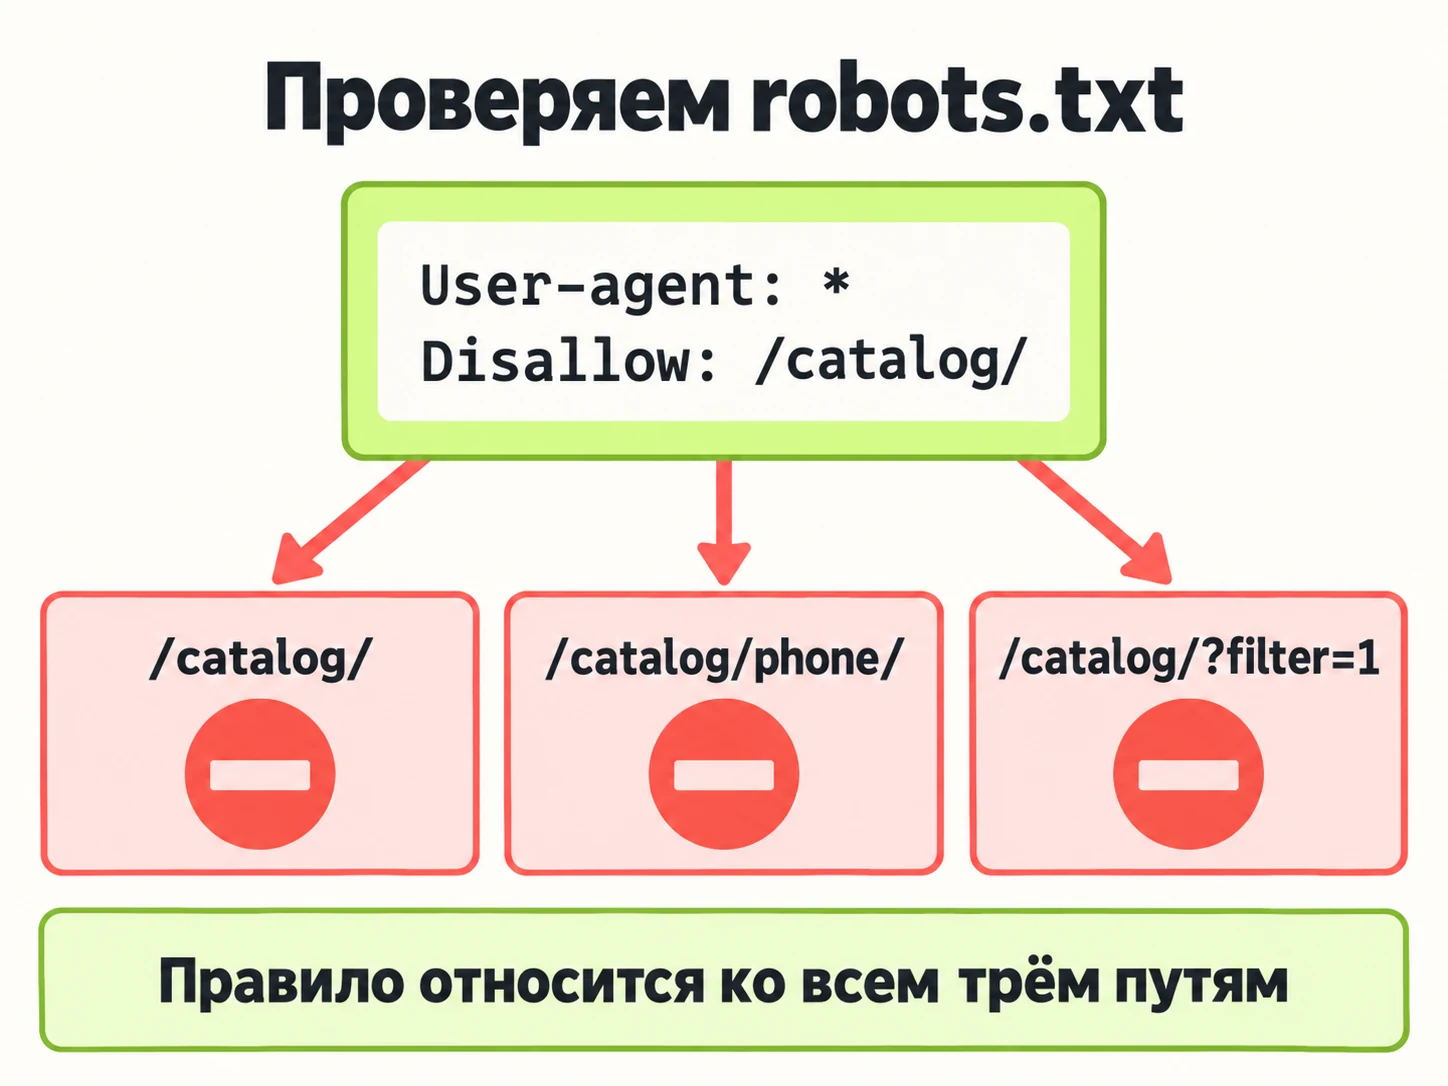
Пример: правило закрывает /catalog/, чтобы ограничить параметры фильтра. Вместе с параметрами под запретом оказываются обычные карточки. Исправление требует карты URL: базовые категории и товары оставляют доступными, а технические комбинации оценивают отдельно. Простое удаление всех правил может открыть бесконечное число вариантов каталога.
Проверьте как минимум три адреса: базовую категорию, нужную карточку и техническую комбинацию фильтров. Для каждого запишите применившуюся группу User-agent и решение тестера robots.txt в Вебмастере. Если правило закрывает полезный товар, правьте его на уровне шаблона путей и снова тестируйте все три адреса. Содержимое robots.txt относится к конкретному протоколу, домену и порту; файл с похожего стенда не доказывает настройки рабочего сайта.
Есть ли запрет индексации в HTML или ответе сервера
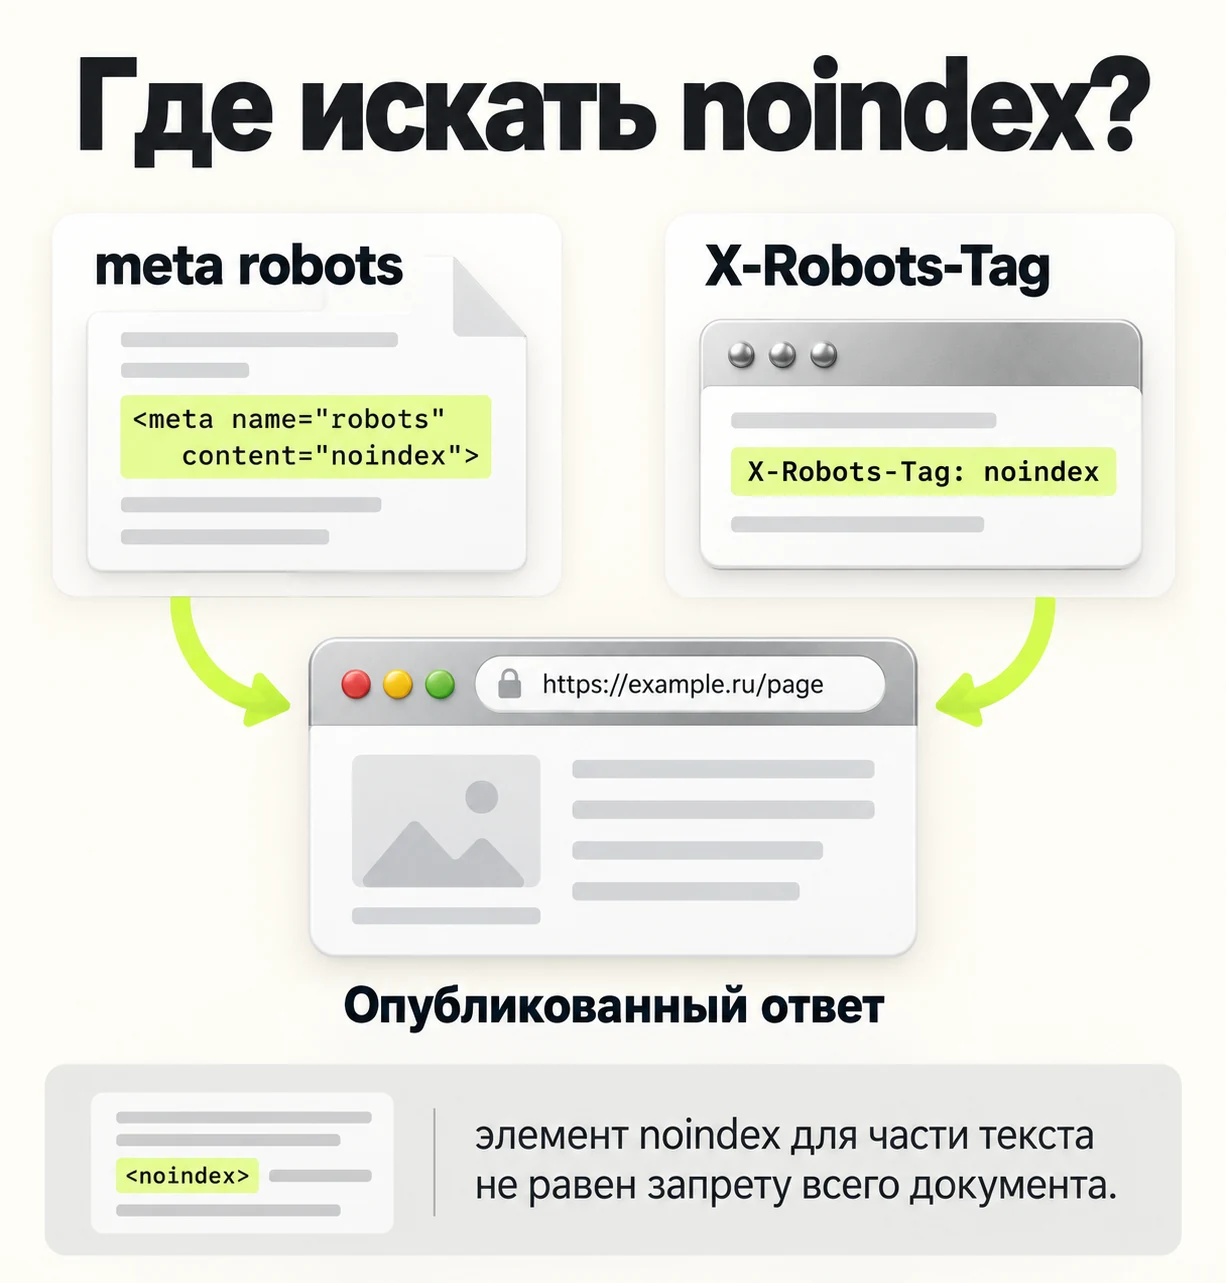
Проверьте meta name="robots", адресованные Яндексу указания и заголовок X-Robots-Tag на конечном URL. Запрет может добавлять система управления сайтом (CMS), плагин, сервер, промежуточный слой или шаблон. Сверяйте опубликованный ответ, а не только код в репозитории. Если noindex найден, определите, нужен ли он этой странице или остался после тестирования.
Яндекс также описывает собственный HTML-элемент <noindex> для части текста. Его наличие вокруг служебного фрагмента не равно запрету индексировать весь URL. Не смешивайте эту конструкцию с метатегом страницы. Записывайте точное место и охват каждой директивы.
После снятия запрета повторно получите HTML и HTTP-заголовки. Если CMS генерирует несколько слоёв, один из них может вернуть директиву снова. В протоколе приёмки укажите и проверенную страницу, и остальные URL того же шаблона.
Для метатега найдите строку в опубликованном head; для X-Robots-Tag сохраните заголовок конечного HTTP-ответа. Проверьте, нет ли одновременно общего robots и указания для робота Яндекса с разными правилами. Если скрипт удаляет noindex только после загрузки, проверьте именно содержимое, доступное роботу; исходный запрет может быть обработан раньше. После исправления один пример карточки не закрывает проверку всей группы: возьмите страницы с разными состояниями товара.
Куда ведёт canonical и какая страница считается основной
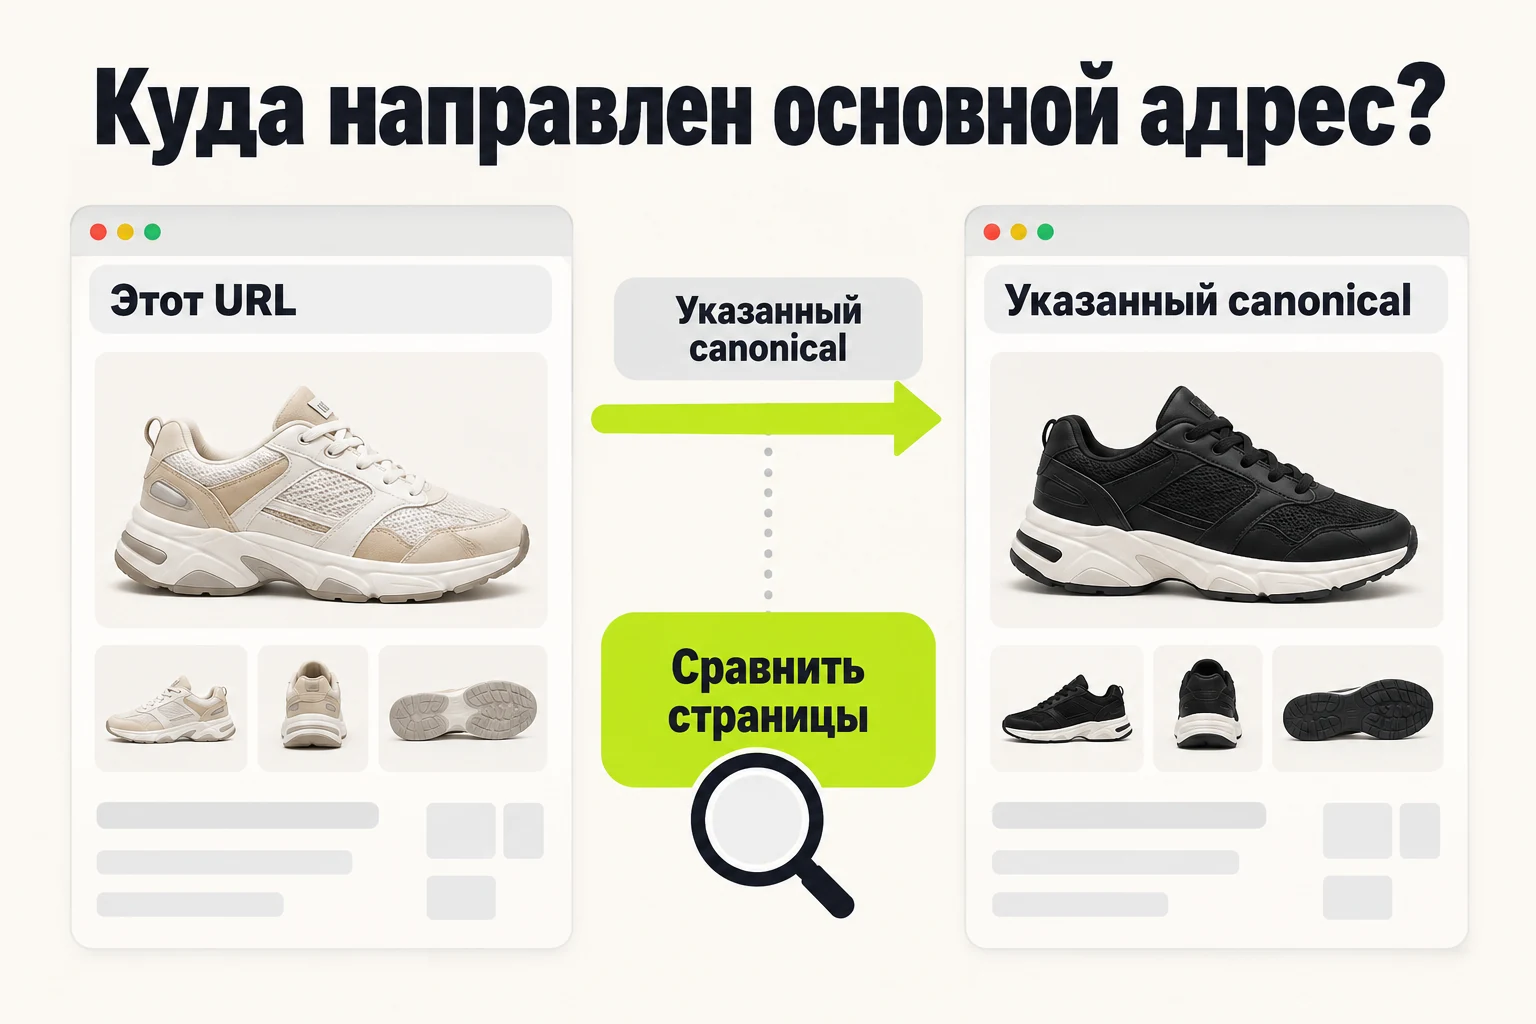
Сравните URL в rel="canonical" с адресом страницы и её реальным содержимым. У варианта сортировки он может указывать на основную категорию. У самостоятельной услуги ссылка на главную часто сигнализирует ошибку шаблона. Если две страницы почти одинаковы, Яндекс может выбрать одну и исключить другую; посмотрите формулировку причины в Вебмастере и сопоставьте обе страницы.
Canonical сообщает о предпочтении, но не заменяет оценку содержимого и внутренние ссылки. Если каждая городская страница содержит одну и ту же услугу с заменённым названием города, простая замена тега не создаст отдельной пользы. Решите, какие адреса действительно должны отвечать на разные вопросы, и только затем согласуйте канонизацию.
После переезда проверьте старый и новый URL вместе: статус перенаправления, конечную страницу, внутренние ссылки, Sitemap и canonical. Если старый адрес ведёт на главную вместо соответствующей услуги, робот и посетитель теряют связь. Подробное планирование переезда находится в материале о переносе сайта на другой домен.
Сделайте запись «исключённый URL → указанная каноническая версия → содержимое обеих страниц». Если канонический адрес открывает другой товар или чужую услугу, причина обычно в шаблоне или сопоставлении данных. Если документы действительно одинаковы, наличие в поиске только одной версии может быть нормальным. Для отдельной страницы услуги проверьте также ссылки из раздела и адрес в Sitemap: противоречащие сигналы затрудняют разбор.
Может ли Яндекс обнаружить нужную страницу
Найдите входящую ссылку из подходящего раздела сайта. Услуга должна быть доступна через каталог услуг или контекстную статью, товар через категорию, статья через блог и связанные материалы. Ссылка должна вести на рабочий URL обычным href. Адрес, который показывается только после ввода во внутренний поиск, может не иметь нормального пути для обнаружения.
Проверьте XML Sitemap: включает ли он нужные канонические URL, получает ли сам файл ответ 200, нет ли там массово редиректов и удалённых страниц. Карта сообщает адреса, но не заставляет поисковую систему включить их в базу. Вебмастер показывает обработку файла отдельно от индексации страниц.
Не подменяйте внутренние ссылки списком тысяч URL в футере. Помогите человеку выбрать: у категории показывайте товары и подкатегории, у статьи следующий полезный материал, у товара связанные модели. Для диагностики запишите путь от известной страницы до проблемного адреса и проверьте каждый переход на телефоне.
Проверьте источник ссылки в HTML: у перехода должен быть адрес в href, а товар или статья должны открываться напрямую после обновления. Если адрес доступен лишь после внутреннего поиска, добавьте его в тематический список или категорию. Для Sitemap отдельно запишите дату последнего разбора файла Вебмастером и ошибки формата. Успешное принятие карты подтверждает обработку файла, но не статус каждой страницы в выдаче.
Как разбирать причины исключения в Вебмастере
В справке Яндекса об исключённых страницах перечислены запреты, редиректы, дубли, неканонические адреса и малоценные или маловостребованные документы. Каждая причина требует своего теста. Для запрета нужен опубликованный robots.txt или метатег. Для редиректа нужен конечный адрес. Для дубля нужно сравнение полезного ответа и URL. Для малоценной страницы проверьте содержание, ассортимент и реальные связи с разделом.
Пример: у карточек товара один и тот же шаблон, но в части товаров нет названия модели, цены и наличия. Робот получает почти пустые страницы. Добавление длинного одинакового абзаца не исправит данные товара. Сначала восстановите реальные поля и путь покупки; затем повторно проверьте образцы разных состояний.
Отдельно осмотрите уведомления о безопасности и нарушениях. Их наличие требует работы по указанной причине. Отсутствие уведомления не доказывает, что все страницы качественны, а малая посещаемость не доказывает наличие санкции. Если доступ к Вебмастеру временно потерян, не объявляйте конкретную причину исключения по догадке.
Не исправляйте все исключения одной операцией. Для 404 определите, должна ли страница существовать. Для редиректа проверьте конечный ответ. Для дубля сравните оба документа. Для «малоценной или маловостребованной» страницы выясните, есть ли уникальная задача и полноценные данные. Яндекс прямо указывает, что такой статус сам по себе не означает нарушение или ограничение ранжирования сайта. В журнале отделите техническую ошибку от редакционной гипотезы, которую нельзя доказать одним статусом.
Когда техника исправна, а страницы всё ещё не включены
Проверьте, отвечает ли документ самостоятельной задаче. У услуги должны быть состав, условия и действие; у категории ассортимент и способ выбора; у товара точная модель и доступность; у статьи воспроизводимый ответ. Страница, где меняется только название города или товара, может не давать нового содержания. Сравните её с выбранным основным адресом и с тем, что пользователь увидит после перехода.
Не все исключённые URL представляют проблему. Параметры сортировки, служебные страницы и удалённые товары могут обоснованно отсутствовать в поиске. Считайте потерей именно важные документы, которые сайт хочет показывать покупателям. Для большого каталога отделяйте число известных роботу комбинаций от числа полезных карточек.
Проверка одной страницы без догадки об алгоритме
Запишите основной вопрос посетителя, прочитайте страницу как независимый покупатель и найдите точный ответ. Затем сравните несколько похожих URL: что уникального в каждом товаре, городе или услуге? Если отличие невозможно назвать и проверить, вернитесь к модели структуры. Формулировка «Яндекс не любит сайт» не является техническим диагнозом.
Что делать после исправления и сколько ждать
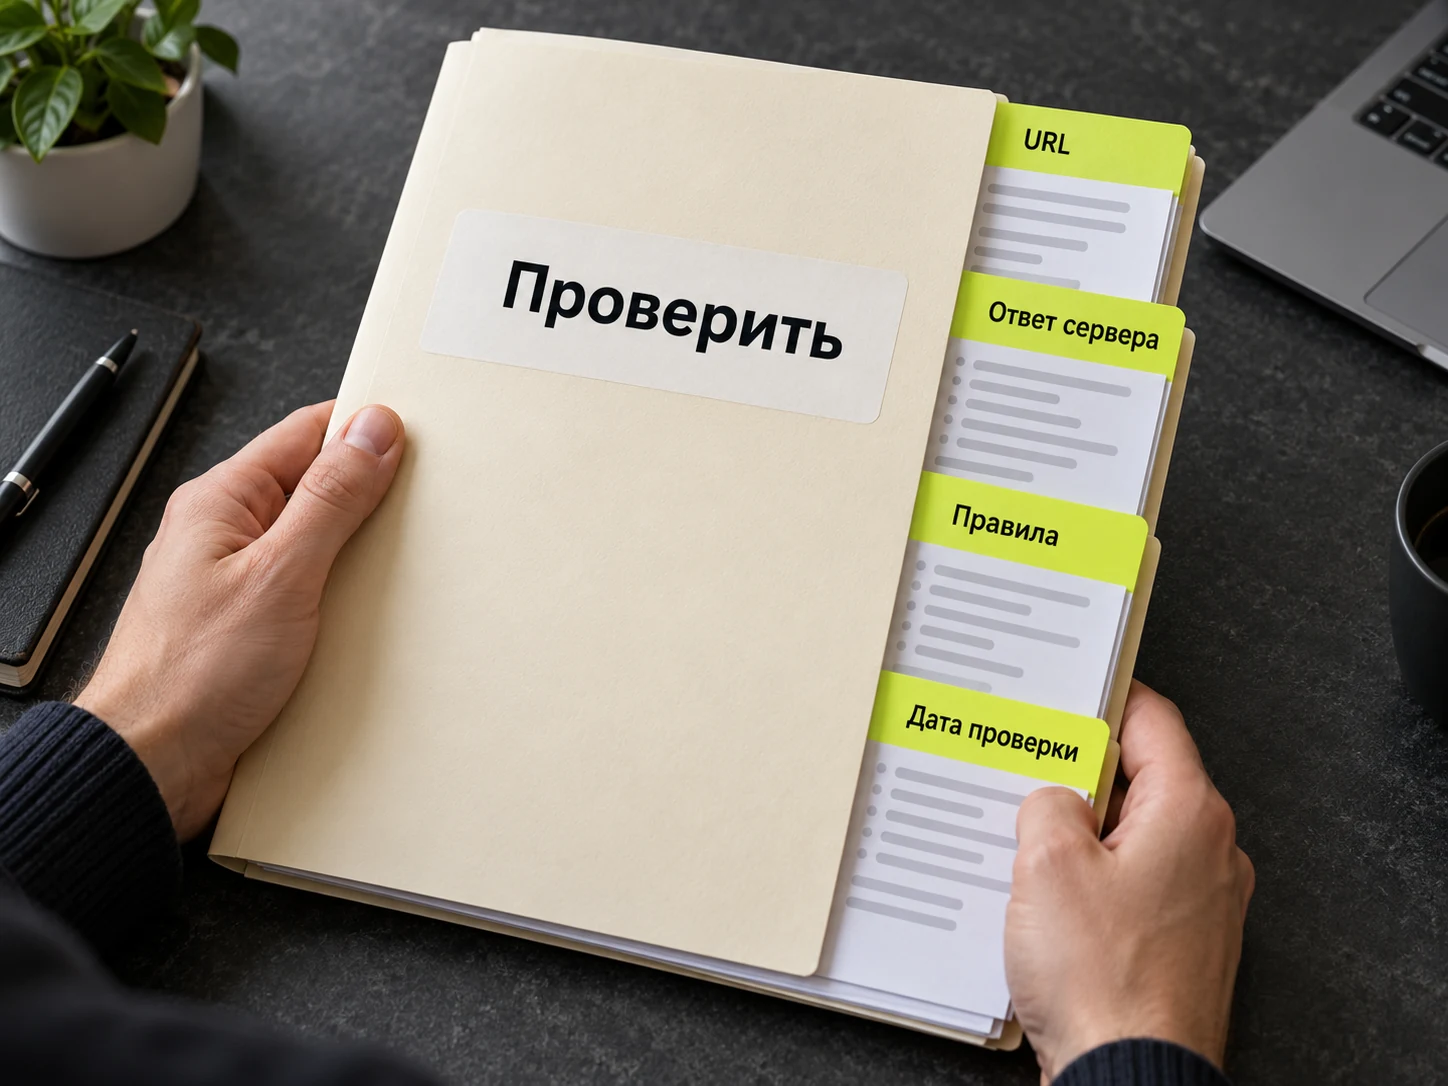
Сначала проверьте опубликованный ответ, запреты, canonical, содержимое и ссылку на страницу. Сохраните дату выпуска и перечень затронутых URL. Затем используйте «Переобход страниц» в Вебмастере для важных изменённых адресов. Яндекс описывает состояние «Заявка обработана» как посещение роботом; это ещё не подтверждение попадания в поиск. Повторные одинаковые заявки не исправят содержимое и не гарантируют ускорения.
Следите за статусом URL и причиной исключения в следующие контрольные дни. В справке Яндекса приведены интервалы работы отдельных инструментов, но сам Яндекс подчёркивает, что не прогнозирует срок индексации сайта и не гарантирует включение. Поэтому не обещайте клиенту «точно через неделю». Если после нового обхода причина осталась прежней, повторите соответствующий тест на опубликованной версии.
В карточке проблемы держите два результата: «ошибка на сервере устранена» и «адрес участвует в поиске». Например, запрос переобхода получил статус «Заявка обработана» после снятия запрета. Это означает посещение, но не переводит вторую строку в «да». Для неё нужен отдельный актуальный статус URL в Вебмастере. Если кабинет всё ещё показывает старую причину, сначала сопоставьте дату последнего обхода с датой публикации правки.
Как учитывать исправленные адреса
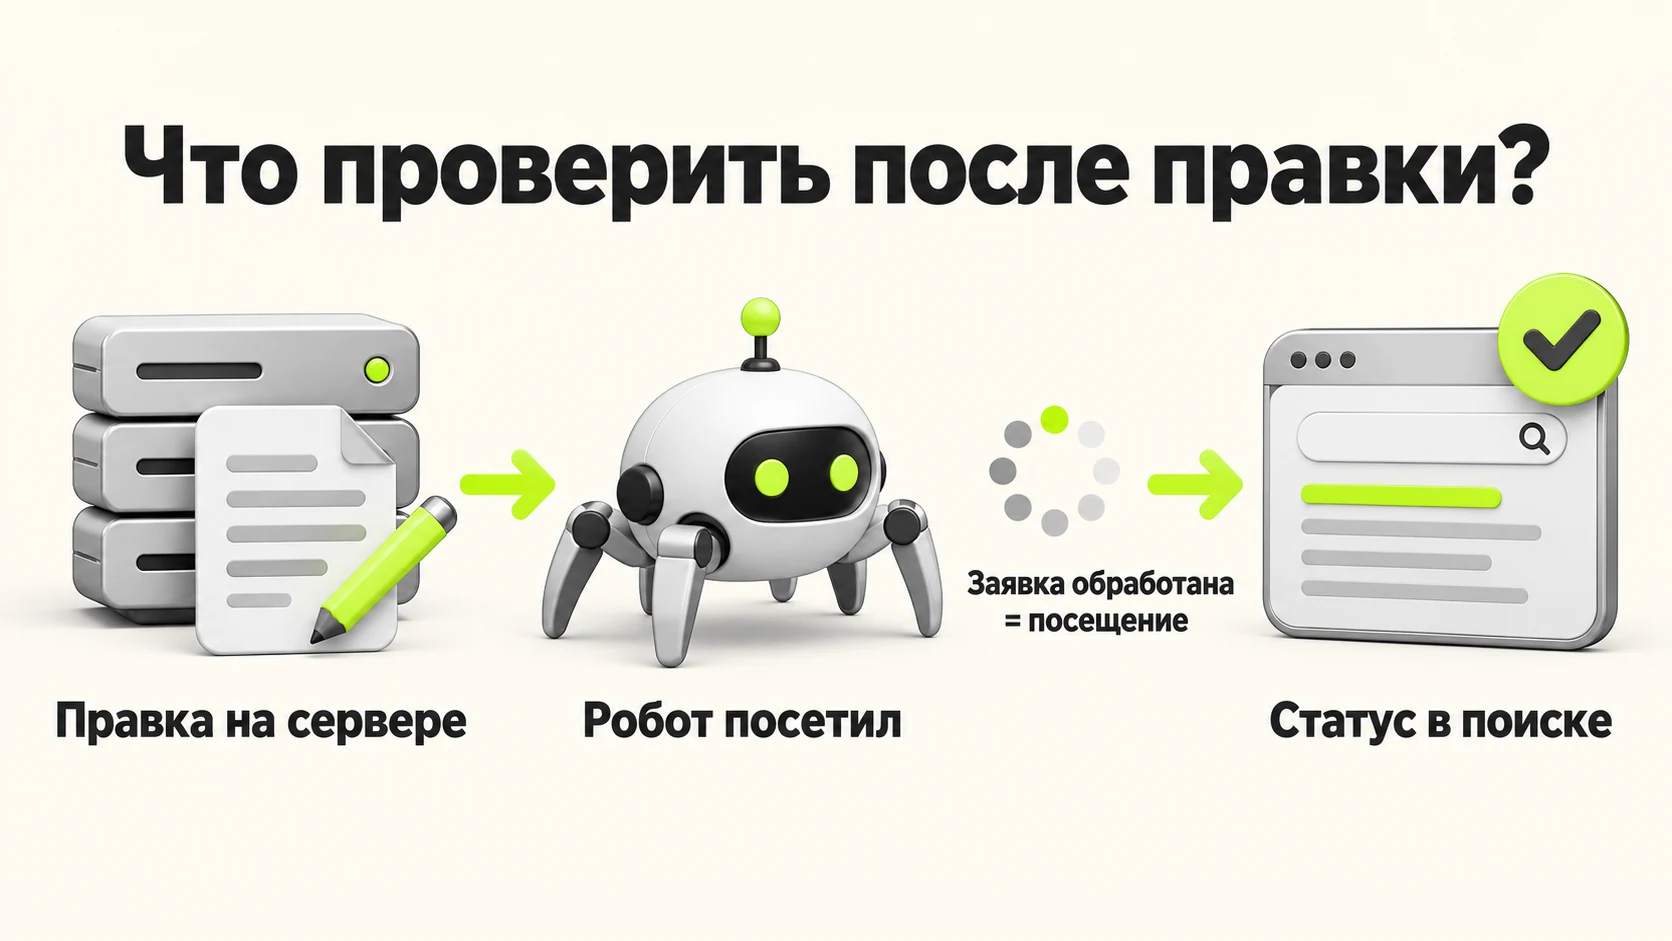
В примере 20 важных страниц: 6 были закрыты общим noindex, 3 перенаправлялись на неверные адреса, остальные 11 получили ответ 200 без этих ошибок. После выпуска подтвердили исправление всех 6 запретов и 3 редиректов на опубликованном сайте: технически исправлено 9 / 9 найденных препятствий. Это не означает «9 страниц вернулись в поиск». Их поисковый статус проверяют отдельно после обхода.
Для этого же условного примера заведите отдельный столбец «в поиске после нового обхода». Если пока проверены только четыре из девяти исправленных адресов, нельзя писать «вернулись 4 / 9»: они могли лишь пройти технический тест. Запишите «проверено в кабинете 4 / 9», а внутри этих четырёх укажите точные статусы. Остальные пять остаются «ожидают проверки», а не «не индексируются». Это сохраняет знаменатели и не превращает отсутствие свежих данных в отрицательный результат.
Если на двух из четырёх проверенных URL кабинет подтверждает участие в поиске, корректная запись звучит так: «2 в поиске, 2 имеют указанные причины исключения, 5 ещё не проверены после нового обхода». Отношение 2 / 4 описывает только уже проверенную часть; 2 / 9 было бы неверным показателем восстановления всех исправленных адресов, пока судьба остальных неизвестна. Сохраните даты для каждой строки и перечень URL. Этот условный расчёт нужен для контроля проекта, а не предсказывает скорость работы Яндекса.
Какие данные передать специалисту по индексации
Подготовьте список проблемных URL по типам страниц, исходный и конечный ответ сервера, точные директивы, канонический адрес, ссылку из раздела, сообщение Вебмастера и дату последнего изменения. Добавьте историю переездов, обновлений CMS и массовых изменений каталога, если они совпадают с началом проблемы. Для формулировки задачи укажите, какие адреса должны участвовать в поиске и почему.
| Вопрос при приёмке | Подтверждение |
|---|---|
| Исправлена ли опубликованная ошибка? | Повторный ответ URL и контроль соседних шаблонов |
| Появился ли путь к странице? | Рабочая внутренняя ссылка и корректный Sitemap |
| Увидел ли робот обновление? | Дата обхода и новый статус в Вебмастере |
| Включена ли страница в поиск? | Отдельный статус конкретного URL в кабинете |
Если общая причина затрагивает десятки шаблонов или уведомление о нарушении требует отдельного расследования, передайте эти материалы на SEO-аудит сайта. Исполнитель должен назвать подтверждённую причину, список затронутых адресов, правку и повторный тест. Полная инструкция по выборке и приоритетам проверки есть в статье о самостоятельном SEO-аудите.
Удобный порядок передачи проблемы: сначала один точный URL и его роль для покупателя, затем конечный HTTP-ответ, применимое правило robots.txt, метатег или заголовок, canonical, путь из раздела и сообщение Вебмастера с датой. Добавьте один соседний адрес того же шаблона для сравнения. Если доступ к Вебмастеру отсутствует, это поле остаётся незаполненным с причиной. Так исполнитель может воспроизвести техническую часть и запросить только недостающие права, а владелец понимает, какое утверждение уже доказано.
После внедрения не оценивайте успех только по общему числу страниц в поиске. Оно может вырасти за счёт параметров фильтра или упасть после правильного удаления дублей. Вернитесь к заранее составленному списку важных URL и их целям. Для каждого проверьте ответ сервера, путь по ссылке и актуальный статус участия в поиске. Если URL в поиске, но не получает подходящих показов, следующий вопрос относится уже к соответствию запросу и содержанию, а не к запрету индексации.
Пример диагностической записи для условного URL https://example.com/catalog/item/: GET возвращает 200 и карточку товара; файл robots.txt допускает путь; в опубликованном HTML найден noindex; в отчёте исключений указан запрет с более ранней датой. Действие: определить, какой шаблон выставляет директиву, снять её только для нужных карточек и проверить соседний отсутствующий товар отдельно. Приёмка: новый HTML и заголовки не содержат запрета на выбранных адресах. Статус участия в поиске будет подтверждён позже в отдельной графе.
Другой условный случай: URL возвращает 200 и не содержит запретов, но Вебмастер считает его дублем. Сравните его с указанной основной страницей, включая модель товара, варианты и условия покупки. Если они совпадают, исключение вторичной версии может быть ожидаемым. Если на одном адресе другая модификация, проверьте canonical, предвыбор варианта и ссылки из категории. Добавление текста ради «уникальности» без исправления выбора товара может оставить проблему покупателя и робота.
При массовой ошибке составьте перечень URL до правки. Разделите его по шаблонам и сохраните несколько образцов исходных ответов. После выпуска повторите автоматическую проверку всех адресов из перечня и ручную проверку разных состояний шаблона. Если доступ восстановлен лишь на одном образце, задача ещё не принята. И наоборот, отсутствие немедленного роста страниц в поиске не отменяет проверенного технического исправления; внешний статус записывается после обновления данных Вебмастера.
Документация и источники
Редакция Webclub. Опубликовано 2026-10-03, обновлено 20.10.2026.
Обсудим задачу вашего сайта?
Пришлите адрес и опишите, что хотите исправить. Согласуем состав работ и порядок проверки.
ПОСМОТРЕТЬ СОСТАВ РАБОТ

