27 правил SEO.
Проверьте сайт вместе с ИИ.
Найдите, что мешает поисковику увидеть сайт. Разберите ошибки по шагам — или передайте проверку Codex и Claude Code с готовым скиллом.

Содержание статьи
Технический SEO-аудит проверяет, может ли поисковик получить страницу, прочитать её и выбрать нужный адрес для индекса. Эти 27 пунктов помогают найти препятствия после разработки, переноса или обновления сайта.
Они не заменяют полезный контент, анализ спроса и предложение для клиента. Исправный сайт получает возможность конкурировать; место в выдаче одной проверкой не гарантируется.
Начните с главной, важной услуги, статьи и ещё нескольких типичных страниц. Для магазина добавьте категорию и товар. Не переносите результат одной страницы на весь сайт.
Скилл, который проверяет, а не просто советует
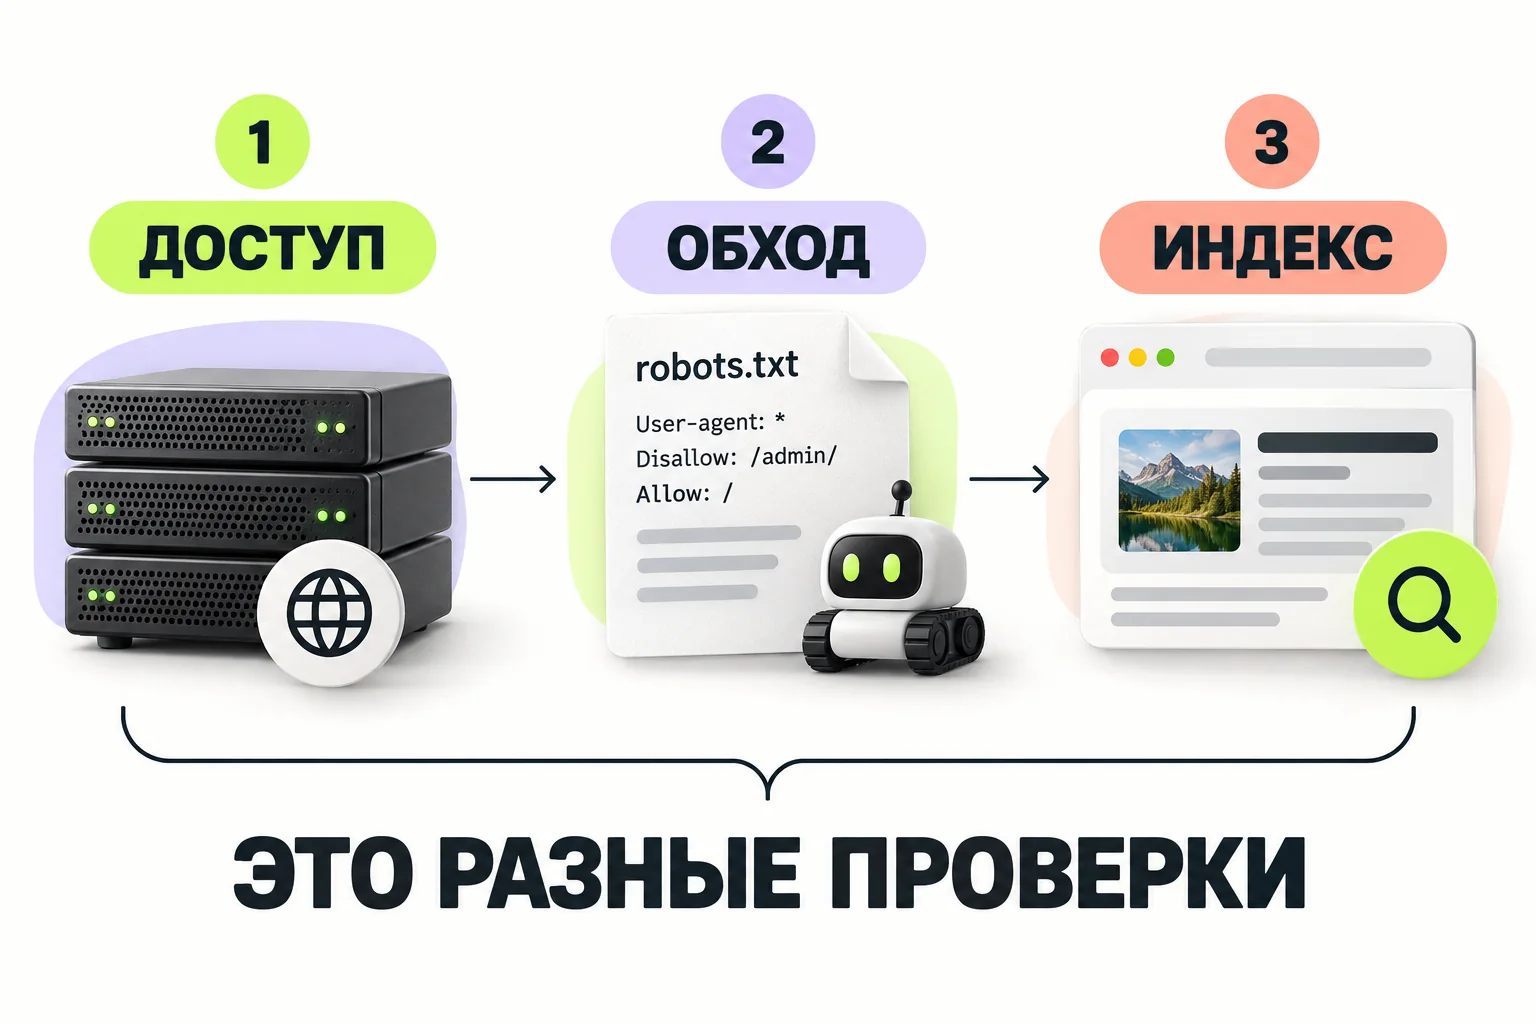
Это набор инструкций и инструментов для Codex и Claude Code. Помощник изучает проект, собирает доступные факты по 27 пунктам и формирует отчёт с приоритетами.
- 27 строк в таблице. Проверки нельзя незаметно пропустить.
- Доказательства рядом с выводом. Адрес, код ответа, файл или данные кабинета.
- Понятные действия. Что исправить, зачем и как проверить результат.
- HTML, CSV и Markdown. Отчёт можно открыть в браузере, передать разработчику или распечатать в PDF.
Версия 1.0.0 · ZIP, около 50 КБ · платные API не требуются. Пример отчёта содержит учебные данные. Ваши результаты помощник соберёт отдельно.
Как установить и запустить
- Скачайте ZIP и распакуйте его. Внутри — файл INSTALL.md и папка webclub-seo27. Переносите папку целиком, вместе со scripts, assets и references.
- Откройте папку своего сайта. Для Codex поместите скилл в
.agents/skills/webclub-seo27/. Для Claude Code — в.claude/skills/webclub-seo27/. Это две альтернативы, выбирайте своего помощника. - Начните новую сессию. В Codex вызовите
$webclub-seo27, в Claude Code —/webclub-seo27. Если команда не появилась, попросите прочитать SKILL.md по полному пути. - Вставьте задание ниже. Замените домен на свой. Исходники помогут найти причину ошибки в шаблоне; для отчётов индексации понадобится доступ к соответствующему кабинету или выгрузка из него.
Проверь мой сайт по скиллу webclub-seo27.
Домен: https://ВАШ-ДОМЕН/
Исходники: текущая папка проекта.

Не меняй сайт. Проверь все 27 пунктов. Для большой площадки сначала возьми главную и по нескольку страниц каждого шаблона, явно укажи границы выборки.
Для каждого вывода сохрани доказательство: URL, ответ сервера, фрагмент кода, скриншот или данные кабинета. Если доступа нет — напиши «Нет данных», не ставь «В порядке».

Создай audit.json и отчёт в HTML, CSV и Markdown. В HTML нужны сводная диаграмма, таблица всех 27 проверок, фильтры по статусу и подробные исправления. В конце дай пять первых действий с приоритетами и способом перепроверки. Пароли и токены в отчёт не включай.
Помощник создаст отдельную папку отчёта. Два вспомогательных скрипта работают на Python 3.10+ без сторонних библиотек. Запускать их вручную не обязательно: скилл объясняет помощнику, как собрать наблюдения и оформить результат.
Что находится внутри архива
SKILL.md— порядок аудита и требования к доказательствам.references/checks.md— все проверки с критериями и источниками.scripts/collect.py— ограниченный сбор HTTP-ответов и HTML, по умолчанию до 20 страниц с учётом robots.txt.scripts/report.py— проверка структуры данных и создание отчёта.assets/report.example.json— учебный пример. Он не подменяет результаты вашего сайта.
Скилл предназначен для помощника с доступом к проекту и инструментам. Простая загрузка архива в обычный чат не даёт ему доступ к серверу, браузеру или Search Console. Недоступные проверки останутся со статусом «Нет данных».
Устройство скиллов: документация Codex и Claude Code.
Как читать отчёт и не обмануть себя
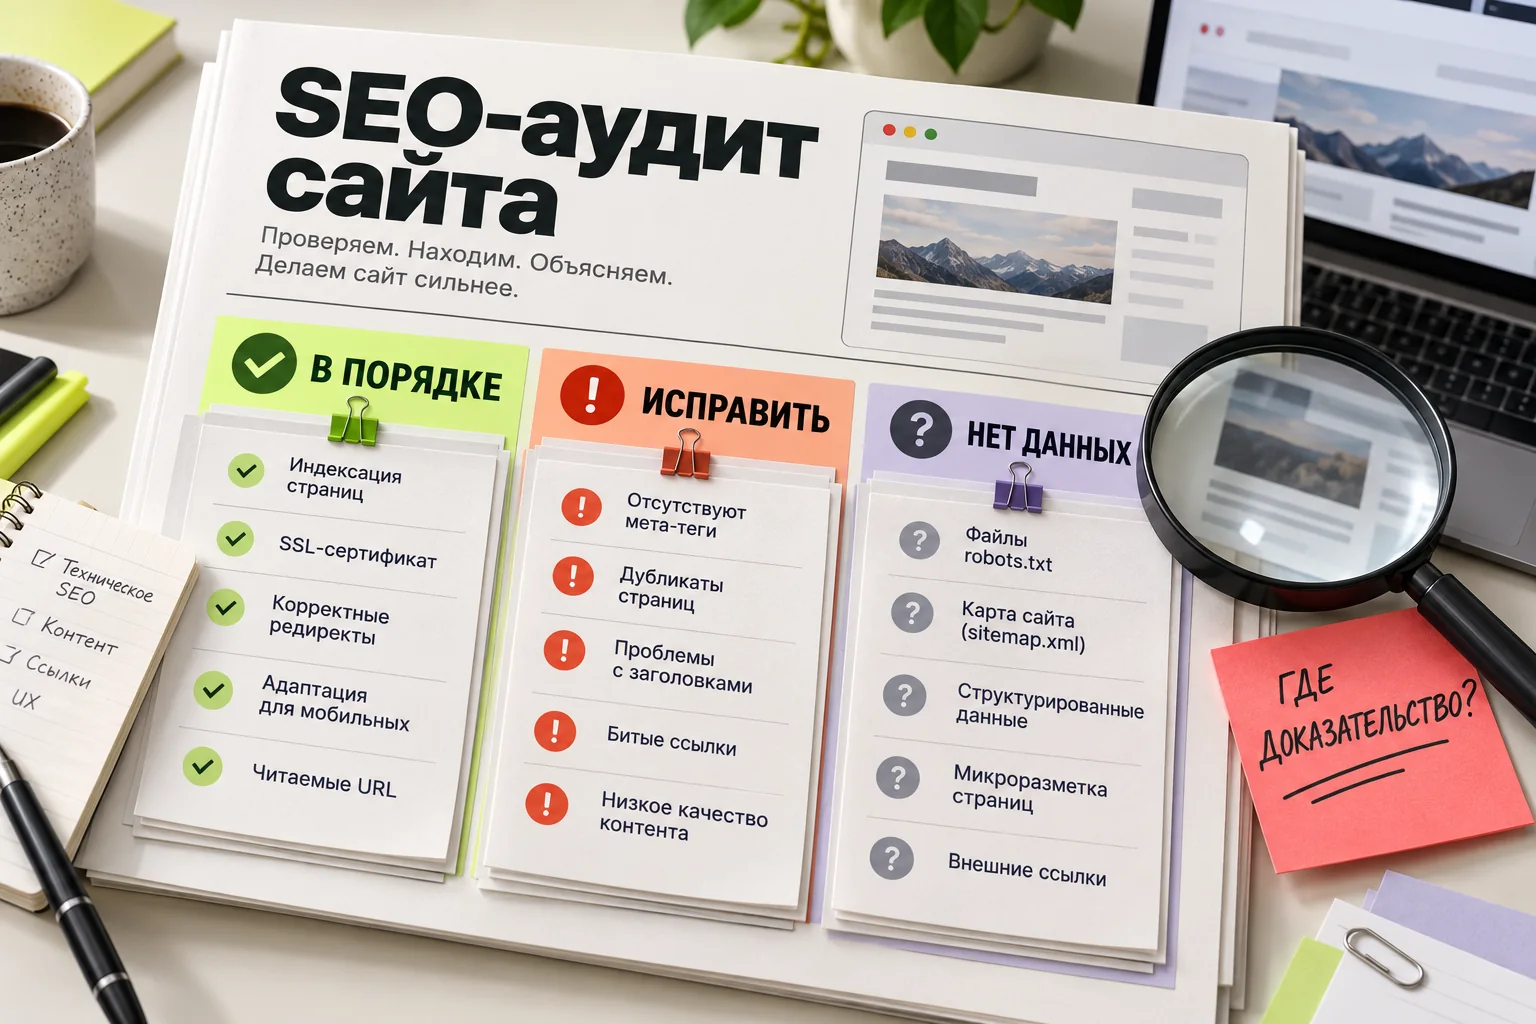
| Статус | Что означает | Следующее действие |
|---|---|---|
| В порядке | Проверка выполнена, критерий соблюдён в указанной выборке. | Сохранить доказательство. |
| Ошибка | Найдено подтверждённое нарушение. | Исправить по приоритету. |
| Нужно внимание | Есть риск, неоднозначность или улучшение. | Разобрать контекст. |
| Нет данных | Не хватает доступа или измерения. | Получить данные, повторить проверку. |
| Не применимо | Пункт не относится к проекту, причина объяснена. | Не создавать лишнюю задачу. |
Например, открытая страница в браузере подтверждает доступ для вашего браузера. Она не доказывает, что WAF пропускает настоящий Googlebot. А оценка Lighthouse не заменяет данные реальных посетителей.
Отчёт показывает границы выборки: сколько страниц просмотрено, какие инструменты использованы и чего проверить не удалось. Не называйте проверку пяти страниц полным обходом магазина на десять тысяч товаров.
1. HTTPS: сайт открывается без предупреждений
Просроченный сертификат мешает открыть сайт ещё до знакомства с услугами. Проверить нужно основной домен, вариант с www и переход с HTTP.
Что проверить
- Откройте главную и внутреннюю страницу в приватном окне. В информации о соединении проверьте имя домена и срок сертификата.
- Введите адрес с http://. Он должен привести к выбранной HTTPS-версии без циклов и длинной цепочки переходов.
- В DevTools → Console проверьте mixed content: картинки, скрипты и формы не должны загружаться по небезопасному HTTP.
Если нашли проблему. Настройте выпуск и автоматическое продление сертификата, корректную цепочку и редирект. Исправьте HTTP-адреса ресурсов в шаблонах.
Готово, когда: Обе проверенные страницы открываются по HTTPS с действительным сертификатом; ссылки и формы работают.
Важная деталь. Успешный ответ с отключённой проверкой TLS ничего не доказывает. Не проверяйте сертификат командой с флагом -k.
2. Cloudflare и WAF: защита не закрывает сайт роботам
WAF — фильтр входящих запросов. Иногда он вместо страницы отдаёт проверку браузера. Человек проходит её, а поисковик не получает содержимое.
Что проверить
- Если защита установлена, откройте её журнал событий и найдите блокировки важных URL.
- Сопоставьте время запроса, действие правила и подтверждённого поискового робота. Одна надпись Googlebot в User-Agent не подтверждает принадлежность Google.
- Проверьте URL средствами Search Console и Вебмастера. Сохраните результат и дату.
Если нашли проблему. Исправьте конкретное правило, мешающее проверенным роботам. Учитывайте порядок правил и отдельные механизмы защиты. Не отключайте весь WAF ради одной страницы.
Готово, когда: Проверенный робот получает страницу, а не CAPTCHA или заглушку защиты; подтверждение есть в журнале или инструменте поисковика.
Важная деталь. Cloudflare не обязателен для продвижения. Если его нет, проверяют фактически установленную защиту. Запрос с подменённым User-Agent — лишь дополнительная диагностика.
3. Геоблокировка: проверяем доступ из нужных сетей
Правило «пускать только Россию» может зацепить поисковых роботов, сервисы проверки и клиентов за границей.
Что проверить
- Посмотрите ограничения по странам, сетям и IP в CDN, WAF и на сервере.
- Проверьте важные страницы из доступных разрешённых точек и инструментами поисковиков. Запишите, откуда выполнялась проверка.
- Найдите в журналах подтверждённые запросы Google и Яндекса и их коды ответа.
Если нашли проблему. Сузьте ошибочное правило и отдельно учтите подтверждённых роботов. Не создавайте исключение только по строке User-Agent: её легко подделать.
Готово, когда: Есть доказательство доступа поисковых роботов и посетителей из целевых регионов. Проверка из одного домашнего браузера не считается проверкой геоблокировки.
Важная деталь. IP поисковиков меняются. Для проверки используйте официальную процедуру DNS/IP, а не случайный список из статьи.
4. Robots.txt: важные страницы разрешены к обходу
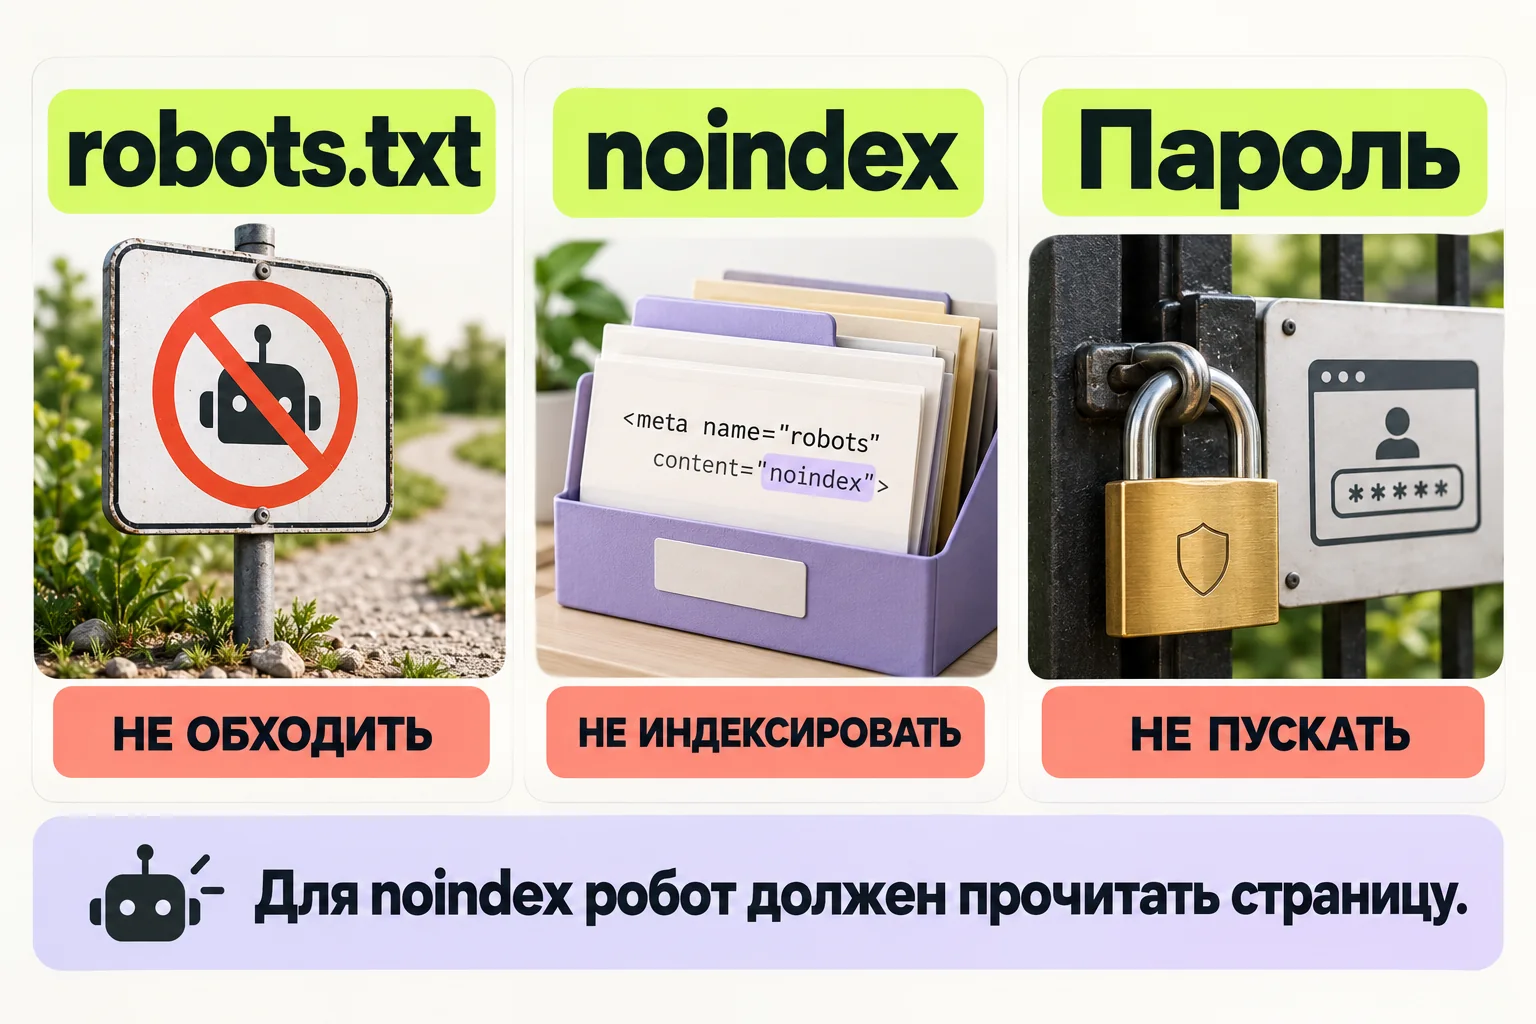
Файл по адресу /robots.txt задаёт правила обхода. Ошибка в общей группе или в группе конкретного робота способна закрыть целый раздел.
Что проверить
- Откройте /robots.txt и убедитесь, что это текст правил, а не HTML главной или страницы ошибки.
- Проверьте главную, услугу и статью в анализаторе robots.txt Яндекс Вебмастера. Отдельно посмотрите правила для Googlebot и Yandex.
- Сопоставьте Disallow и Allow с реальными путями. Проверьте доступ к CSS и JavaScript, нужным для отображения страницы.
Если нашли проблему. Удалите случайный запрет для продвигаемых URL. Служебные разделы оставьте закрытыми там, где это предусмотрено устройством сайта.
Готово, когда: Важные адреса доступны нужным роботам. Разрешение обхода ещё не означает, что страница включена в индекс.
Важная деталь. Disallow не является надёжным способом удалить известный URL из поиска и не защищает приватные данные.
Официальная документация по этой проверке
5. JavaScript: сравниваем исходный HTML и отрисованную страницу
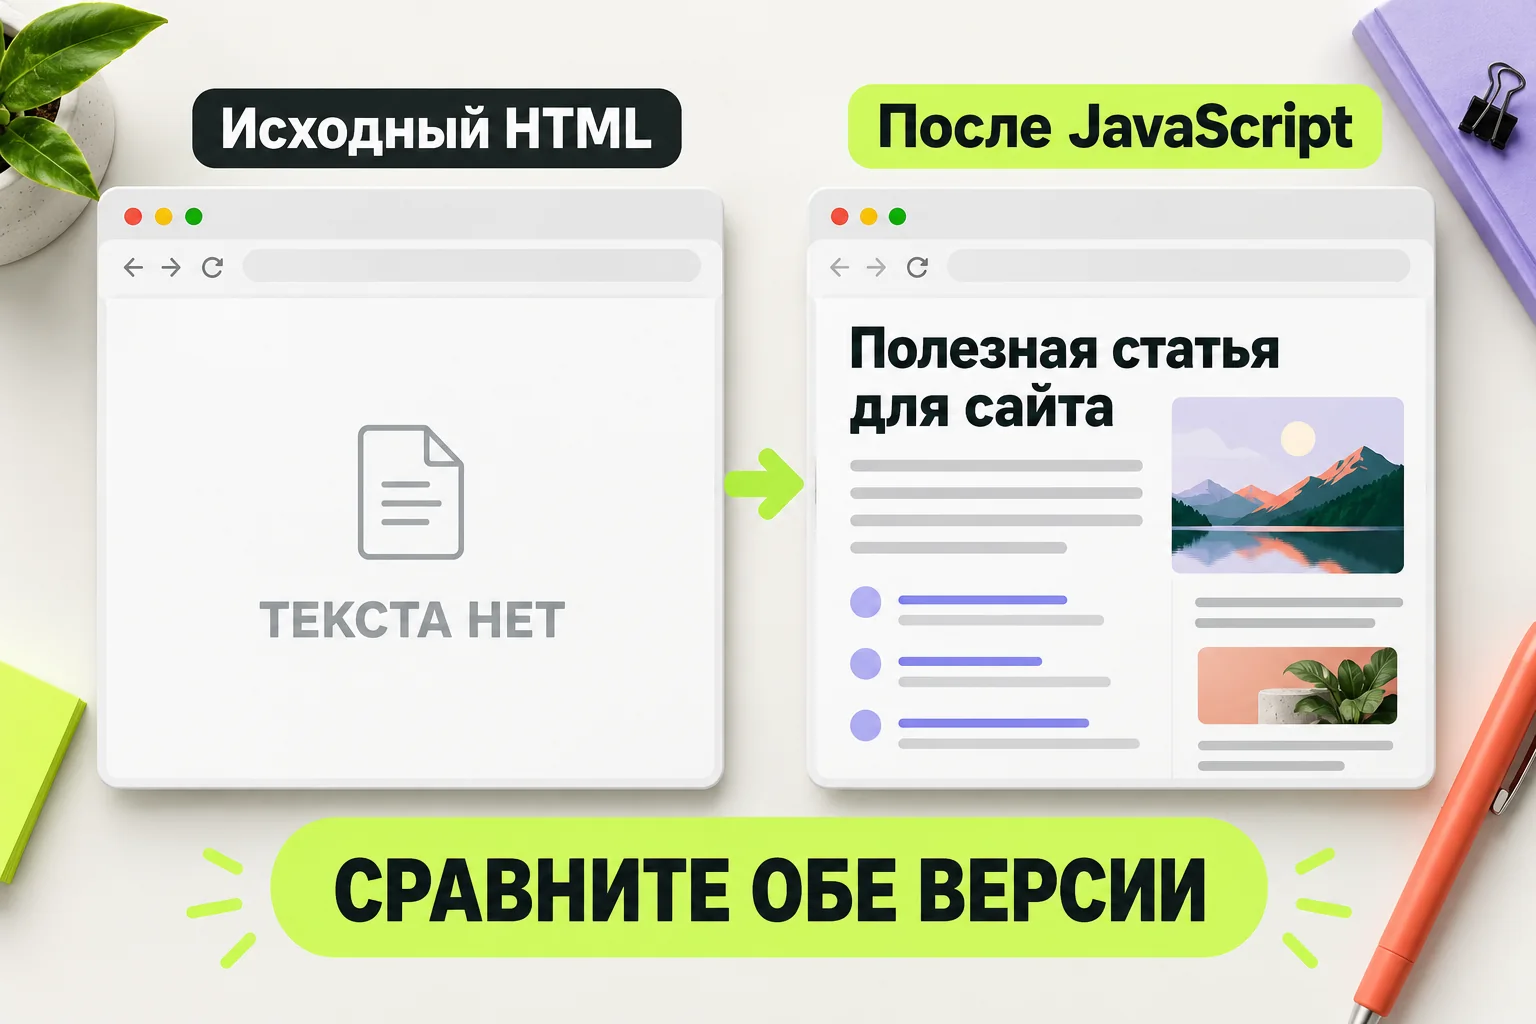
При CSR браузер собирает страницу с помощью JavaScript. В исходном ответе иногда есть только пустой контейнер, а текст зависит от отдельного запроса к API.
Что проверить
- Откройте исходный код страницы и найдите заголовок, основной текст и ссылки.
- Сравните его с DevTools → Elements после загрузки. Проверьте ошибки Console и неудачные запросы Network.
- Откройте проверку опубликованного URL в Search Console и изучите полученный HTML и снимок. Не подменяйте эту проверку обычным браузером.
Если нашли проблему. Для публичных страниц рассмотрите серверную или статическую отрисовку. Сохраните доступ к ресурсам, исправьте ошибки API и сделайте ссылки обычными a href.
Готово, когда: Робот получает содержимое страницы и ссылки. В отчёте отдельно указано, что найдено в HTML, в браузере и в проверке поисковика.
Важная деталь. JavaScript сам по себе не запрещает индексацию. Пустой исходный HTML — повод проверить отрисовку, а не доказательство полного отсутствия страницы в поиске.
Официальная документация по этой проверке
6. Noindex: ищем запрет в HTML и HTTP-заголовках
Страница может открываться и находиться в sitemap, но запрещать индексацию через meta robots или заголовок X-Robots-Tag.
Что проверить
- В исходном HTML найдите meta name=robots и отдельные правила для поисковых роботов.
- В DevTools → Network выберите запрос документа и посмотрите Response Headers → X-Robots-Tag.
- Проверьте основной URL после всех редиректов. Для PDF и других файлов особенно важен HTTP-заголовок.
Если нашли проблему. Уберите случайный noindex в настройке окружения, шаблоне или серверном правиле. Затем повторите GET-запрос и проверку URL.
Готово, когда: У страниц, которые должны участвовать в поиске, нет действующего запрета. Преднамеренно закрытые страницы перечислены отдельно.
Важная деталь. Чтобы поисковик увидел noindex, ему нужен доступ к обходу. Не закрывайте ту же страницу в robots.txt, если рассчитываете на обработку noindex.
7. Preview-домены: тестовая версия не попадает в поиск
Тестовые копии создают лишние адреса и могут раскрывать ещё не опубликованные материалы. При переезде настройки тестовой среды иногда остаются на основном сайте.
Что проверить
- Составьте список известных preview-адресов из настроек хостинга и проекта. Не нужно перебирать чужие поддомены.
- Проверьте, закрыта ли тестовая версия паролем или контролем доступа. Для общедоступного preview проверьте noindex.
- Отдельно проверьте production: пароль, noindex и тестовый canonical не должны случайно переноситься туда.
Если нашли проблему. Разделите настройки окружений. Приватный preview закройте авторизацией; общедоступный исключите из индекса корректной директивой.
Готово, когда: Известные тестовые копии закрыты согласно назначению, основной домен доступен и индексируем.
Важная деталь. Секретный URL и robots.txt не заменяют пароль. Если списка preview нет, результат проверки должен быть «нет данных», а не «копий нет».
8. URL: понятные адреса без бесконечных дублей
Читаемый адрес помогает понять содержание. Основная техническая проблема возникает, когда сортировки, метки и сессии создают множество копий одной страницы.
Что проверить
- Посмотрите адреса услуг, статей и фильтров. Выпишите параметры, которые меняют содержание, и параметры, которые только отслеживают переход.
- Проверьте, не создают ли календарь, сортировка или поиск бесконечное число доступных комбинаций.
- Сопоставьте выбранные адреса с canonical, внутренними ссылками и sitemap.
Если нашли проблему. Задайте единый способ формирования URL и обработку дублей. Новым страницам давайте короткие смысловые пути.
Готово, когда: У каждой продвигаемой страницы есть стабильный адрес, а правила параметров описаны и последовательно применяются.
Важная деталь. Параметры и кириллица сами по себе не ошибка. Не переименовывайте уже работающие URL ради красоты: сначала оцените трафик, ссылки и необходимость редиректов.
9. Хеш-роутинг: у разных страниц есть отдельные URL
Адреса вида /#/services и /#/contacts переключают экран через фрагмент после решётки. Для отдельных поисковых страниц такой способ маршрутизации неудобен.
Что проверить
- Откройте каждую важную услугу в новой вкладке и посмотрите адрес.
- Проверьте прямой переход по этому адресу после перезагрузки, а не только нажатие кнопки внутри приложения.
- Убедитесь, что навигация содержит a href с полноценными путями.
Если нашли проблему. Для публичных услуг и статей используйте пути вроде /services/ и /contacts/. Настройте прямую отдачу нужной страницы сервером.
Готово, когда: Каждая самостоятельная страница имеет отдельный открываемый URL. Сервер не возвращает одну и ту же главную вместо всех адресов.
Важная деталь. Якорь /article/#price внутри одной статьи оставляйте: он помогает навигации и не является хеш-роутингом приложения.
10. Sitemap.xml: перечисляем нужные поиску страницы
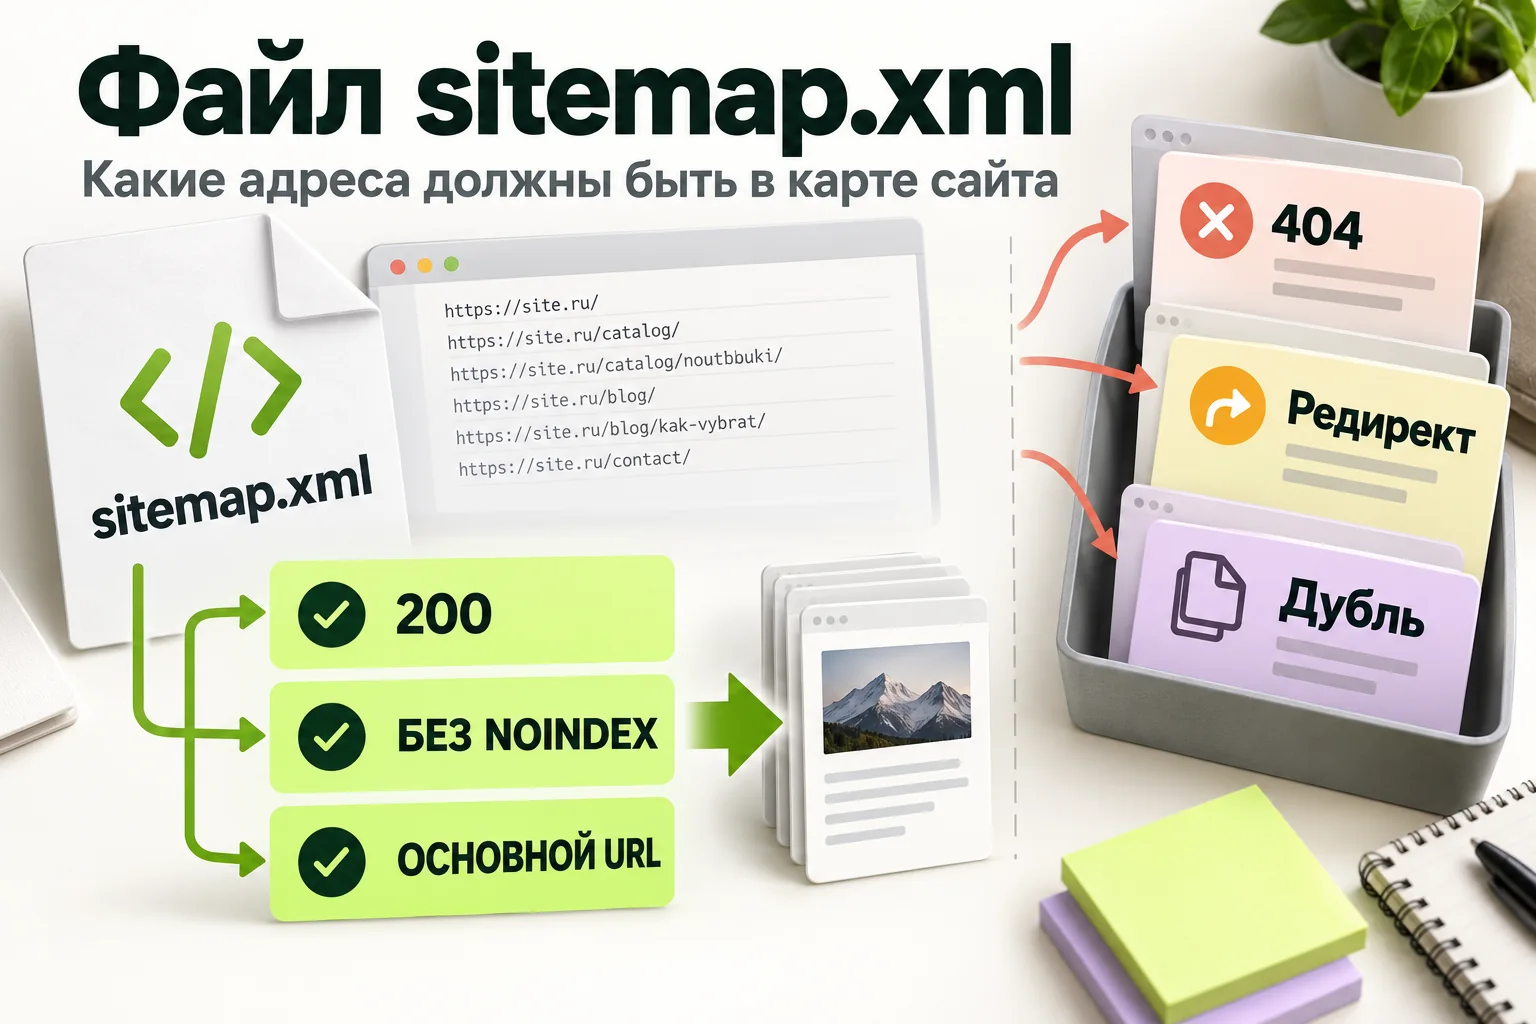
Карта сайта помогает сообщить поисковику об адресах. Она должна совпадать с тем, что сайт действительно предлагает индексировать.
Что проверить
- Откройте sitemap из robots.txt. Если это индекс карт, проверьте вложенные файлы.
- Сверьте выборку адресов: успешный ответ, отсутствие noindex, корректный canonical, актуальное содержимое.
- Проверьте карту в Search Console и Вебмастере. lastmod должен отражать содержательное изменение, а не каждое открытие сайта.
Если нашли проблему. Исключите удалённые URL, редиректы, ненужные дубли и закрытые страницы. Добавьте отсутствующие важные адреса.
Готово, когда: XML читается, ссылки актуальны, адреса соответствуют стратегии индексации. В отчёте указано, сколько URL реально проверено.
Важная деталь. Добавление URL в sitemap не гарантирует индексацию. Не помещайте в карту каждую комбинацию фильтров только потому, что она существует.
Официальная документация по этой проверке
11. Перелинковка: связываем страницы по задаче читателя
Читателю нужен следующий шаг, а поисковику — доступный путь к странице. Статья о ремонте может вести к услуге, смете и примерам работ.
Что проверить
- Проверьте, есть ли ссылки на важную страницу из каталога, связанных статей или других подходящих разделов.
- Посмотрите HTML ссылок: предпочтительна конструкция a href, а не кликабельный div.
- Прочитайте текст ссылки отдельно от абзаца. Он должен объяснять, куда приведёт переход.
Если нашли проблему. Добавьте ссылки там, где они продолжают тему. Исправьте навигацию, из которой робот не может получить адрес назначения.
Готово, когда: Приоритетные страницы доступны по рабочим ссылкам; читатель понимает назначение каждого перехода.
Важная деталь. Страница без входящих ссылок в небольшой выборке ещё не доказанная «сирота». Для такого вывода нужна полная карта внутренних ссылок или инвентаризация проекта.
12. Битые ссылки: исправляем конкретные переходы
Ссылка на несуществующий материал обрывает путь читателя. Важен не только список ошибок, но и страницы, с которых на них переходят.
Что проверить
- Проверьте внутренние ссылки и сохраните пару «страница-источник → сломанный адрес».
- Разделите постоянные 404/410, временные 5xx, таймауты и блокировки 403. Не называйте их одной ошибкой.
- Для внешнего адреса повторите сомнительную проверку позже или откройте его обычным браузером: автоматический запрос могли ограничить.
Если нашли проблему. Замените ссылку подходящим действующим материалом или уберите ненужный переход. При реальном переносе настройте точный редирект.
Готово, когда: Проверенная ссылка ведёт к нужному содержимому. В отчёте указаны исходный URL, адрес назначения, код ответа и дата.
Важная деталь. Старый URL, на который никто не ссылается внутри сайта, может законно отвечать 404. Не перенаправляйте все удалённые страницы на главную.
13. Soft 404: отсутствующая страница не отвечает 200
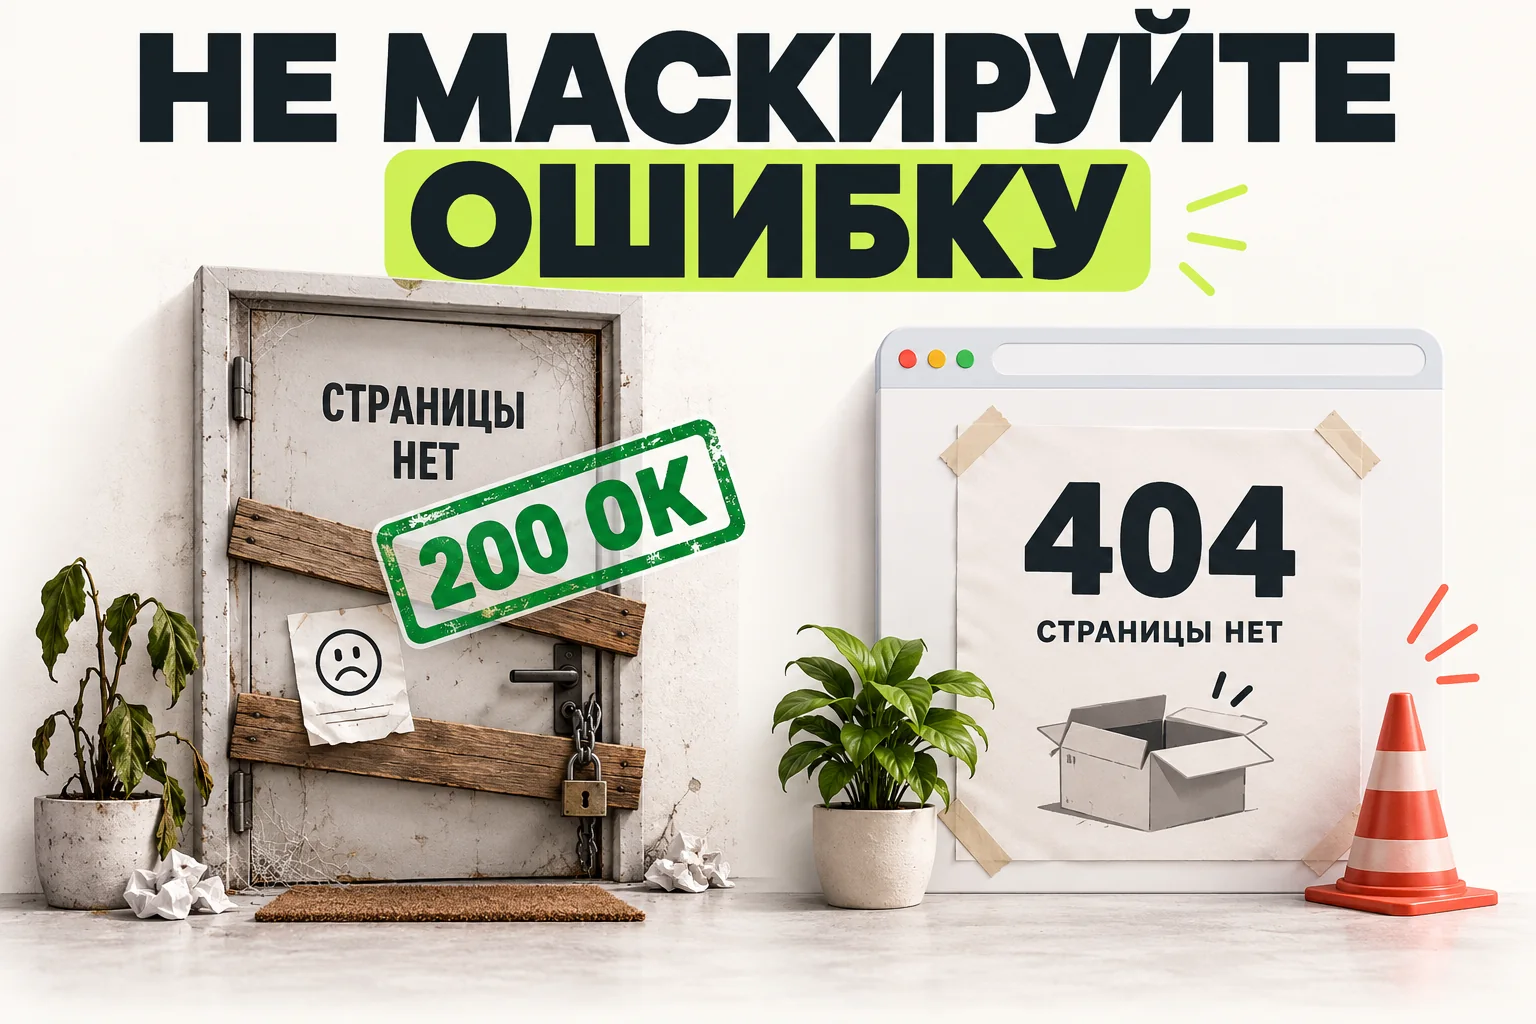
При soft404 сервер сообщает об успехе, хотя посетитель видит «ничего не найдено» или почти пустую страницу. Так бывает после неверной настройки маршрутов.
Что проверить
- Придумайте один заведомо несуществующий путь и откройте его на своём сайте.
- Посмотрите фактический код ответа документа в Network. Красивый экран ошибки не означает код 404.
- Сверьте примеры soft404 в Search Console: причина может быть в пустом содержимом, а не только в тексте «не найдено».
Если нашли проблему. Для удалённого без замены материала возвращайте 404 или 410. Для перенесённого используйте релевантный постоянный редирект. Пустую рабочую страницу восстановите.
Готово, когда: Несуществующий адрес возвращает корректный статус, а нужный материал содержит полноценный ответ.
Важная деталь. Одна проверка случайного пути не доказывает отсутствие всех soft404. Не считайте ответ 200 подтверждением качества содержимого.
Официальная документация по этой проверке
14. Canonical: у дублей согласован основной адрес
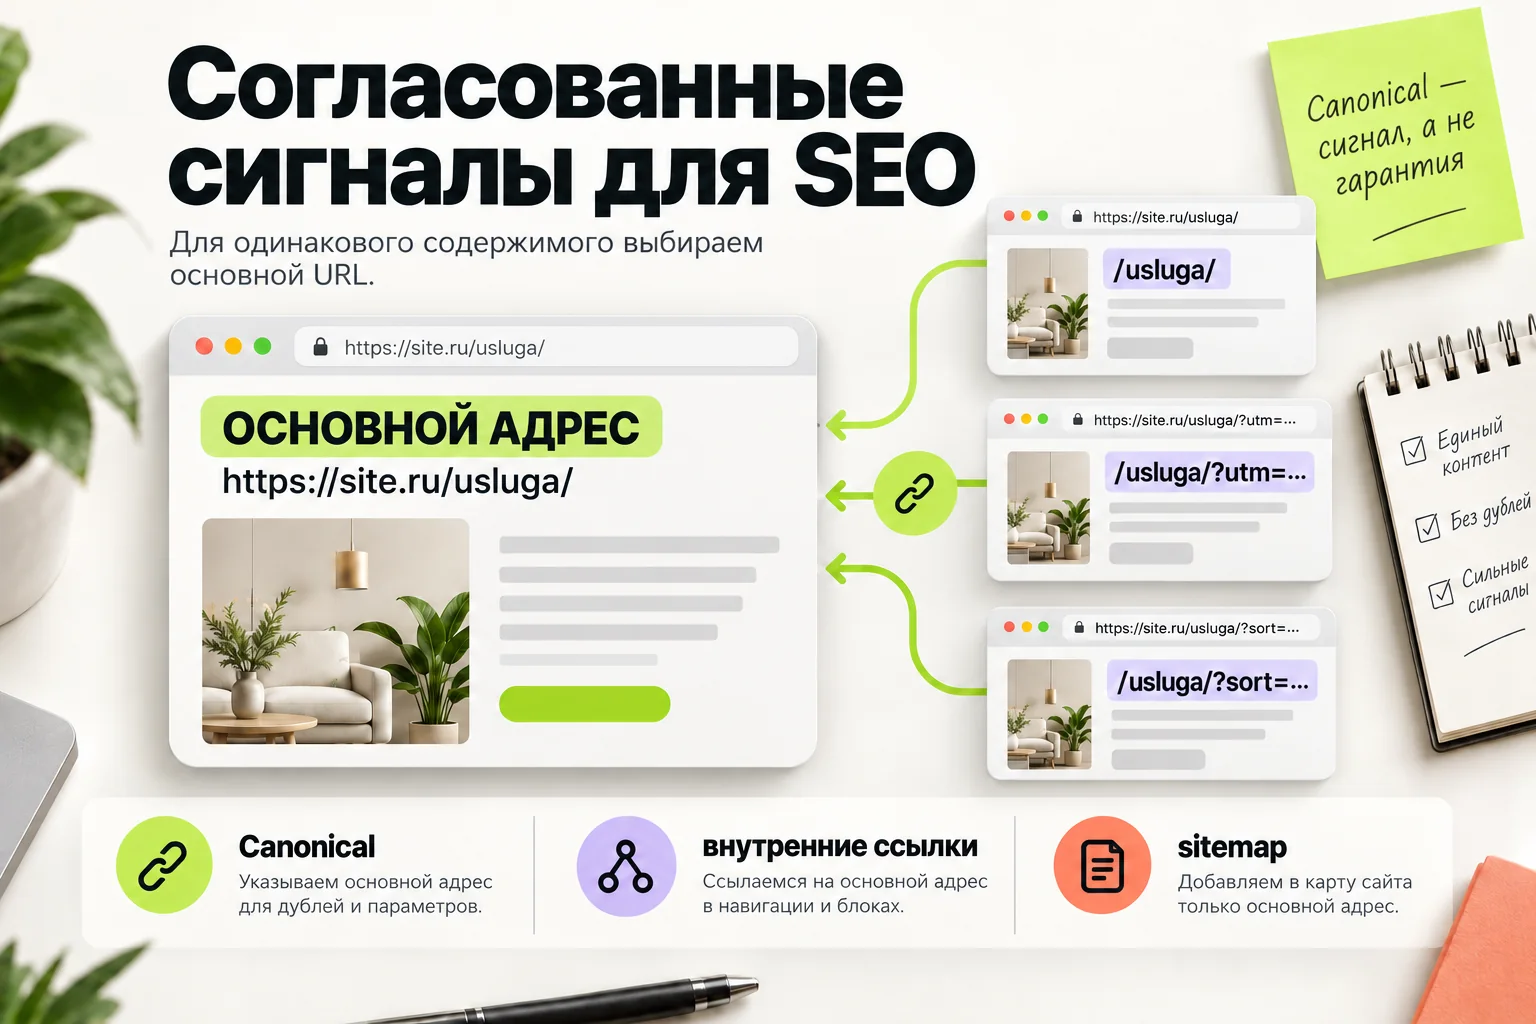
Canonical сообщает предпочтительный адрес среди одинаковых или очень похожих страниц. Его легко ошибочно направить с услуги на главную или соседнюю услугу.
Что проверить
- Посмотрите rel=canonical в HTML и, если используется, HTTP-заголовке Link.
- Откройте целевой адрес: он должен существовать, соответствовать содержанию и не противоречить индексации.
- Сравните canonical с внутренними ссылками, sitemap и выбранной Google канонической страницей в Search Console.
Если нашли проблему. Исправьте шаблон, который подставляет чужой адрес. Для уникальных страниц обычно удобно указывать собственный основной URL.
Готово, когда: Сигналы не противоречат друг другу; у совпадающих страниц выбран осмысленный основной адрес.
Важная деталь. Canonical — сигнал, а не безусловная команда. Не склеивайте им разные услуги или страницы пагинации с различным содержимым просто ради уменьшения числа URL.
15. Localhost в canonical: убираем адрес разработки
После сборки в метатегах иногда остаются localhost,127.0.0.1 или тестовый домен. Посетитель видит рабочий сайт, а технические сигналы ведут в другое место.
Что проверить
- Проверьте canonical, og:url, URL в микроразметке и sitemap у нескольких типов страниц.
- В проекте найдите настройки site, baseUrl, origin и переменные окружения, из которых собирается абсолютный адрес.
- Проверьте итоговый HTML после сборки: правильное значение в исходниках ещё не доказывает правильный выпуск.
Если нашли проблему. Укажите рабочий HTTPS-домен в настройке production и пересоберите затронутые страницы. Ссылки в примерах кода менять не нужно.
Готово, когда: Служебные поля опубликованных страниц содержат рабочие адреса. Текст учебного примера с localhost не помечен как ошибка.
Важная деталь. Поиск строки localhost по всему репозиторию даёт много ложных находок. В отчёт включайте только контекст, который действительно влияет на опубликованную страницу.
Официальная документация по этой проверке
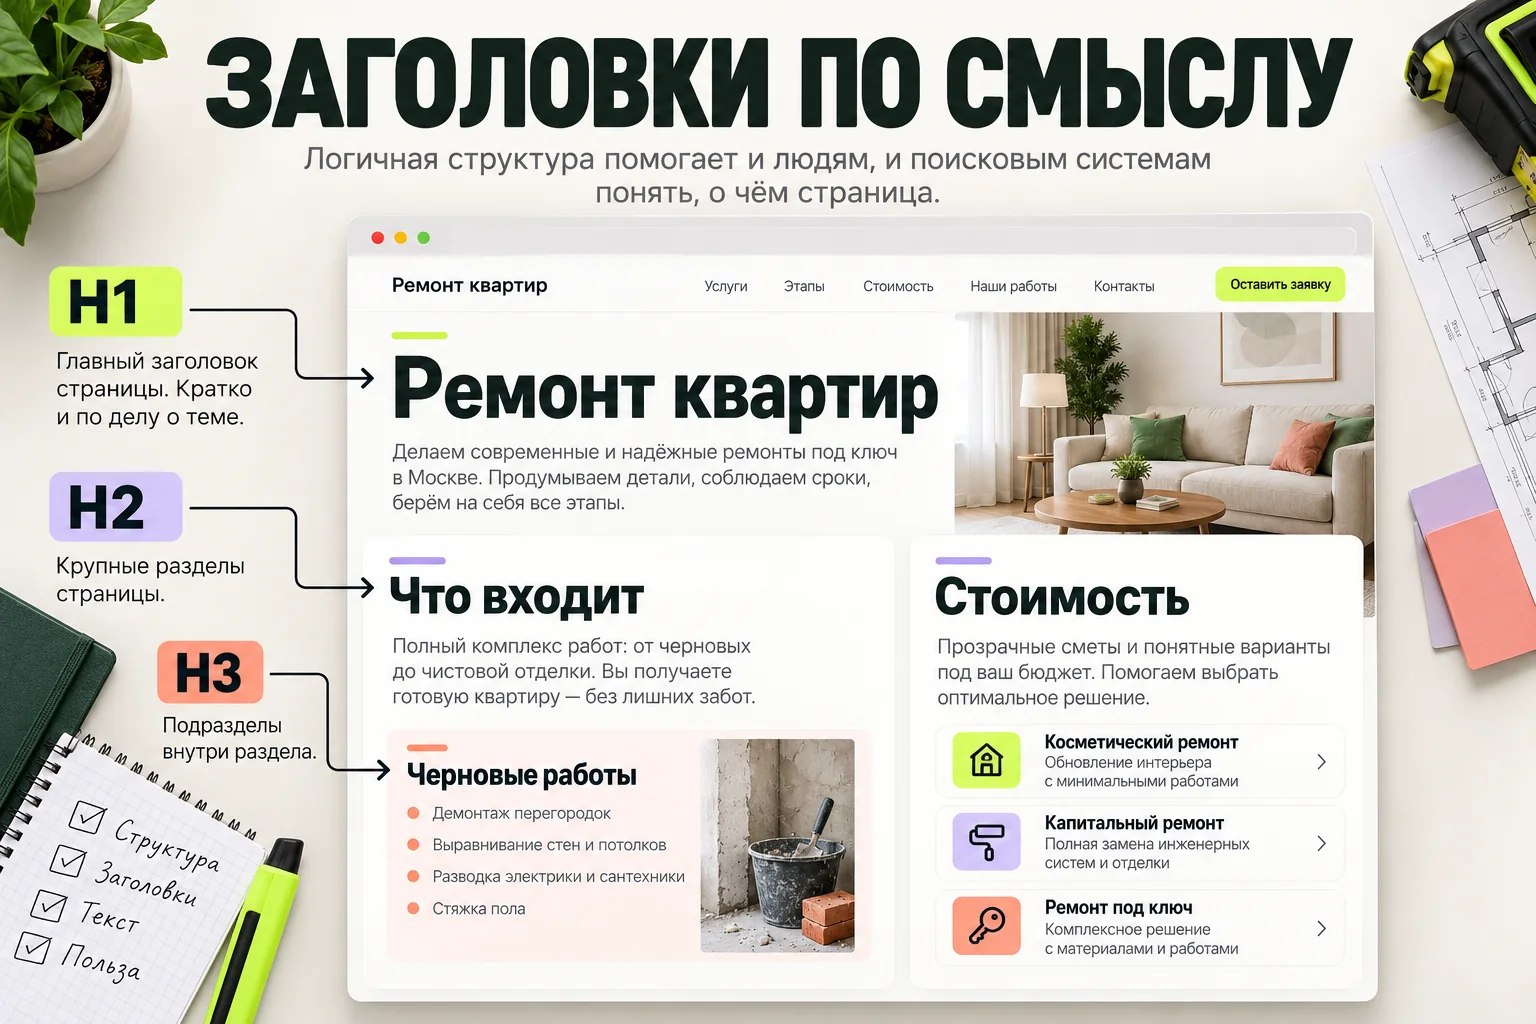
16. H1: посетитель сразу понимает тему страницы
Главный заголовок должен совпадать с задачей страницы. «Ремонт квартир в Краснодаре» понятнее, чем «Воплощаем ваши мечты».
Что проверить
- Прочитайте видимый главный заголовок и проверьте его HTML-уровень.
- Сравните H1 с содержимым, предложением и адресом страницы.
- Проверьте шаблоны: не повторяется ли один общий заголовок на всех услугах.
Если нашли проблему. Назовите конкретную услугу, товар или вопрос. Уберите искусственный перечень ключевых фраз.
Готово, когда: У страницы есть ясный видимый главный заголовок; под ним действительно раскрыта заявленная тема.
Важная деталь. Несколько H1 не означают автоматическую санкцию. Важнее понятная структура; один основной H1 — удобное редакционное правило, а не магическая формула ранжирования.
17. H2 и H3: разделы можно понять без чтения всего текста
Подзаголовки помогают найти цену, условия, этапы или нужный ответ. Размер шрифта и уровень заголовка — разные свойства.
Что проверить
- Соберите список H1–H3 в порядке появления и прочитайте его как оглавление.
- Проверьте, что H3 относится к ближайшему смысловому H2, а не выбран ради внешнего вида.
- Убедитесь, что важные разделы не оформлены просто жирными абзацами, а навигация не забита декоративными заголовками.
Если нашли проблему. Перестройте иерархию по содержанию. Вместо «Наш подход» используйте заголовок, который называет ответ: например, «Как согласуем смету».
Готово, когда: Оглавление передаёт содержание страницы, уровни помогают ориентироваться, пустых разделов нет.
Важная деталь. Пропущенный уровень требует оценки контекста, но сам по себе не доказывает потерю позиций. Не добавляйте H3 только ради наличия всех тегов.
Официальная документация по этой проверке
18. Title: описываем именно эту страницу
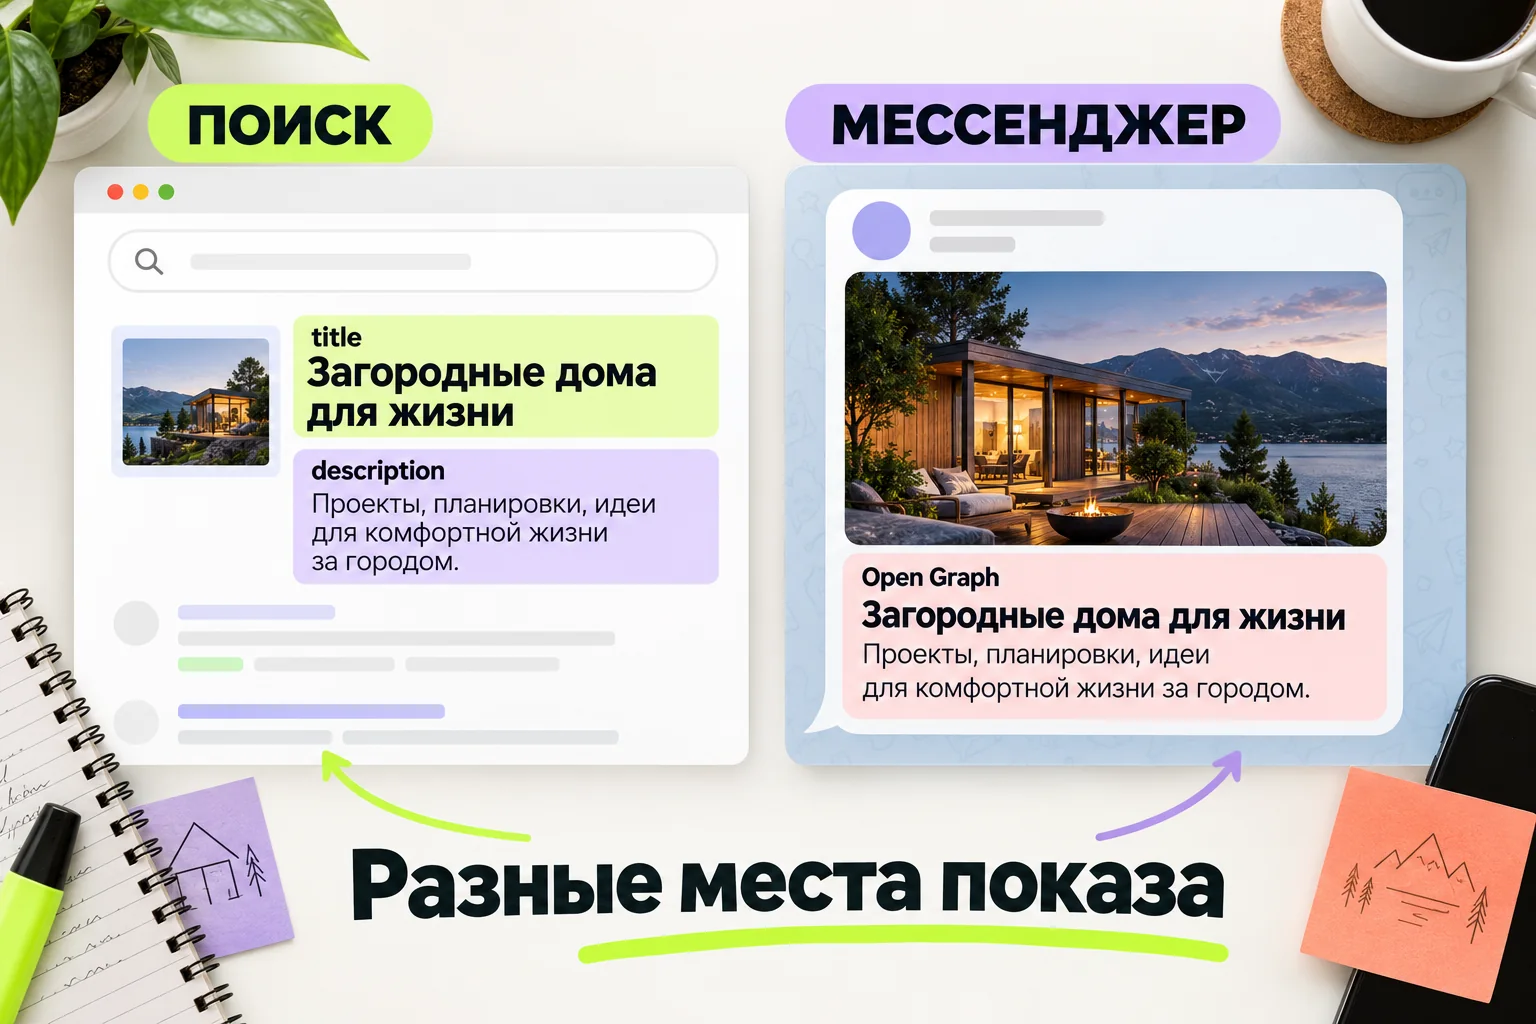
Title помогает обозначить документ; поисковик может использовать его в заголовке результата. Одинаковое «Главная — компания» на всех URL затрудняет различение страниц.
Что проверить
- Посмотрите title исходного HTML и отрисованной страницы.
- Сравните его с H1 и содержимым. Найдите повторы на разных услугах и статьях.
- Проверьте в поиске, какой заголовок показывается пользователю, но не считайте любое переписывание ошибкой сайта.
Если нашли проблему. Укажите тему, полезное уточнение и при необходимости бренд. Сократите повторения; не перечисляйте варианты одного запроса.
Готово, когда: Title конкретный и различимый среди соседних страниц; он не обещает отсутствующие цену, услугу или результат.
Важная деталь. Нет универсального лимита «ровно 60 символов», гарантирующего идеальный показ. Обрезка зависит от ширины и устройства; Google может выбрать другой текст.
19. Description: даём причину открыть страницу
Описание может попасть в поисковый сниппет. Оно должно объяснять содержание, а не повторять список ключевых слов.
Что проверить
- Проверьте meta name=description и отсутствие конфликтующих дублей тега.
- Прочитайте описание глазами посетителя: что он узнает, сравнит или сможет сделать?
- Сверьте обещания с содержимым. Указанные цены, сроки и условия должны быть действительными.
Если нашли проблему. Напишите короткое самостоятельное описание для важных страниц. Например: «Сравниваем черновую и чистовую отделку. Состав работ, пример сметы и порядок согласования».
Готово, когда: Описание соответствует конкретной странице, читается естественно и не вводит в заблуждение.
Важная деталь. Description не обязан дословно появиться в выдаче: поисковик может собрать сниппет из текста под конкретный запрос. Наличие тега не гарантирует рост позиций.
20. Alt: передаём смысл изображения
Альтернативный текст помогает понять изображение, когда его нельзя увидеть. Для графика важно описание вывода, для фотографии товара — различимые свойства.
Что проверить
- Разделите изображения на смысловые, функциональные и декоративные.
- Проверьте alt у значимых картинок. У картинки-ссылки описание должно помогать понять назначение перехода.
- Сопоставьте текст с реальным изображением, а не только с названием файла.
Если нашли проблему. Опишите то, что важно в контексте. Для декоративного элемента используйте alt="". Длинную таблицу или диаграмму дополнительно объясните обычным текстом рядом.
Готово, когда: Смысловые изображения понятны без просмотра, декоративные не создают шум для программы чтения с экрана.
Важная деталь. Пустой alt и отсутствующий атрибут — не одно и то же. Автоматическая проверка не может уверенно решить, декоративна ли фотография.
21. Schema.org: размечаем только существующие данные
Структурированные данные помогают распознать организацию, статью, товар и другие сущности. Но разметка не создаёт отсутствующую цену или отзыв.
Что проверить
- Проверьте JSON-LD и другие используемые форматы в Schema Markup Validator.
- Для поддерживаемых Google типов используйте Rich Results Test. Отдельно проверьте соответствие полей видимой странице.
- Сверьте названия, адреса, автора, URL, цену и наличие товара с реальностью.
Если нашли проблему. Выберите подходящий тип, исправьте ошибки синтаксиса и устаревшие значения. Удалите выдуманные рейтинги, отзывы и сведения о компании.
Готово, когда: Разметка валидна в пределах выбранного типа и отражает реальные данные страницы.
Важная деталь. Успешная проверка не гарантирует расширенный результат в выдаче. Не каждому сайту нужен каждый тип Schema.org.
22. Open Graph: ссылка выглядит понятно в мессенджере
Open Graph задаёт заголовок, описание и картинку для сервисов, которые строят превью ссылок. Это отдельная задача от поискового title.
Что проверить
- Проверьте og:title, og:type, og:url и og:image в HTML.
- Откройте картинку по абсолютному адресу: она должна быть доступна без входа и не вести на localhost.
- Проверьте превью в доступном инструменте предпросмотра. Учитывайте, что сервис мог закэшировать старую картинку.
Если нашли проблему. Подставьте содержательное изображение и заголовок именно этой страницы. Исправьте недоступные адреса ресурсов.
Готово, когда: В превью узнаваемая тема, читаемая картинка и рабочая ссылка.
Важная деталь. Open Graph не является подтверждённой кнопкой роста поисковых позиций. Не понижайте общий SEO-статус сайта до критического только из-за отсутствующего og:image.
Официальная документация по этой проверке
23. Изображения: передаём подходящий размер файла
Фото шириной 6000 пикселей редко нужно для карточки 320 пикселей. Лишний вес расходует время загрузки и мобильный трафик.
Что проверить
- В Network отсортируйте изображения по объёму передачи и найдите самые тяжёлые.
- Сравните размеры исходника и фактический размер показа с учётом плотности экрана.
- Проверьте srcset/sizes, width/height и порядок загрузки. Крупное изображение первого экрана не должно без причины ждать lazy-загрузки.
Если нашли проблему. Подготовьте подходящие размеры, WebP/AVIF там, где они выгодны, и разумное сжатие. Изображения ниже первого экрана можно загружать лениво.
Готово, когда: Картинки читаемы, не занимают лишнюю полосу и имеют зарезервированное место в макете.
Важная деталь. Нет единого предела веса для всех изображений. Не сжимайте схему так, чтобы подписи стали неразличимыми; проверяйте итог глазами.
24. Core Web Vitals: загрузка, отклик и сдвиги
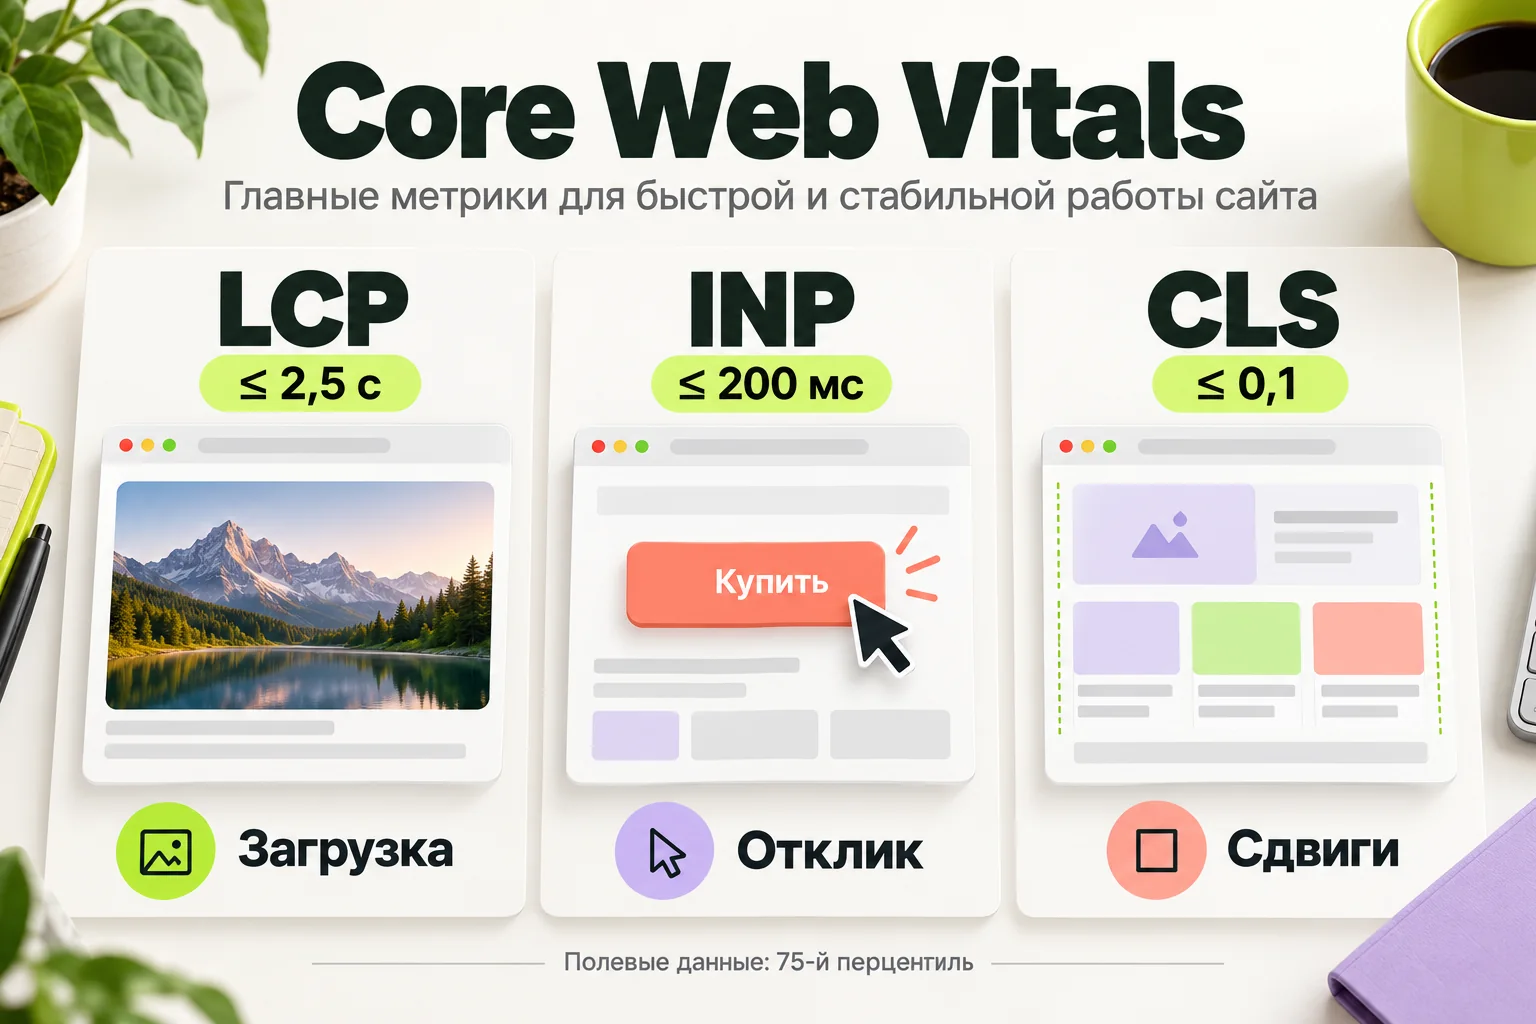
LCP оценивает появление крупнейшего видимого содержимого, INP — задержку реакции на взаимодействие, CLS — неожиданные сдвиги макета.
Что проверить
- Откройте PageSpeed Insights. Сначала посмотрите данные реальных пользователей, если они доступны.
- Ориентиры хорошего результата: LCP≤ 2,5 с, INP≤ 200 мс, CLS≤ 0,1 на 75-м перцентиле. Разделяйте телефон и компьютер.
- Затем изучите лабораторный запуск: какой элемент стал LCP, что блокирует главный поток и какие блоки смещаются.
Если нашли проблему. Исправляйте измеренную причину: тяжёлый первый экран, задержку сервера, лишний JavaScript, незарезервированное место для изображений и вставок.
Готово, когда: В отчёте отдельно показаны полевые и лабораторные данные, URL или origin, устройство и период. После изменения выполнен повторный замер.
Важная деталь. 95 баллов Lighthouse не равны пройденным Core Web Vitals. Отсутствие полевых данных не означает провал; TBT не является измеренным INP.
Официальная документация по этой проверке
25. Мобильная версия: проверяем реальный путь до заявки
Страница может выглядеть аккуратно на компьютере, но обрезать текст, перекрывать кнопку баннером или терять поля формы на телефоне.
Что проверить
- Проверьте узкие экраны 320–390 пикселей и хотя бы один настоящий телефон, если он доступен.
- Пройдите меню, таблицы, модальные окна и поля формы. Убедитесь, что клавиатура не закрывает следующий шаг.
- Сравните основной текст, метатеги и важные ссылки мобильной и настольной версии. Тестовую заявку отправляйте только в согласованную тестовую среду или с разрешения владельца.
Если нашли проблему. Уберите горизонтальное переполнение, увеличьте неудобные зоны нажатия, исправьте форму и перекрытия.
Готово, когда: Человек может прочитать предложение и выполнить целевое действие. Доставка заявки подтверждена отдельно от клика по кнопке.
Важная деталь. Эмуляция телефона полезна, но не проверяет все особенности настоящего устройства. Клик по «Отправить» ещё не доказывает получение заявки.
26. Search Console и Вебмастер: разбираем причины исключения
Не каждый URL должен участвовать в поиске. Редиректы, удалённые страницы и вторичные копии часто исключены намеренно; важнее судьба нужных посадочных страниц.
Что проверить
- Откройте отчёты индексации и выгрузите примеры по каждой причине. Сохраните дату данных.
- Проверьте отдельные важные URL: последний обход, доступность, запреты и выбранный canonical.
- Сопоставьте исторический отчёт с текущей проверкой опубликованной страницы. Исправление сегодня не меняет прошлый обход задним числом.
Если нашли проблему. Устраните причину для нужных страниц, обновите карту и при необходимости запросите повторный обход доступными средствами кабинета.
Готово, когда: Для каждого исключённого примера есть решение: исправить, оставить как задумано или собрать недостающие данные.
Важная деталь. Проверка опубликованной страницы показывает текущую доступность, а не гарантирует её наличие в индексе. Запрос индексации тоже не гарантирует включение.
27. Бэклинки: оцениваем площадку и смысл ссылки
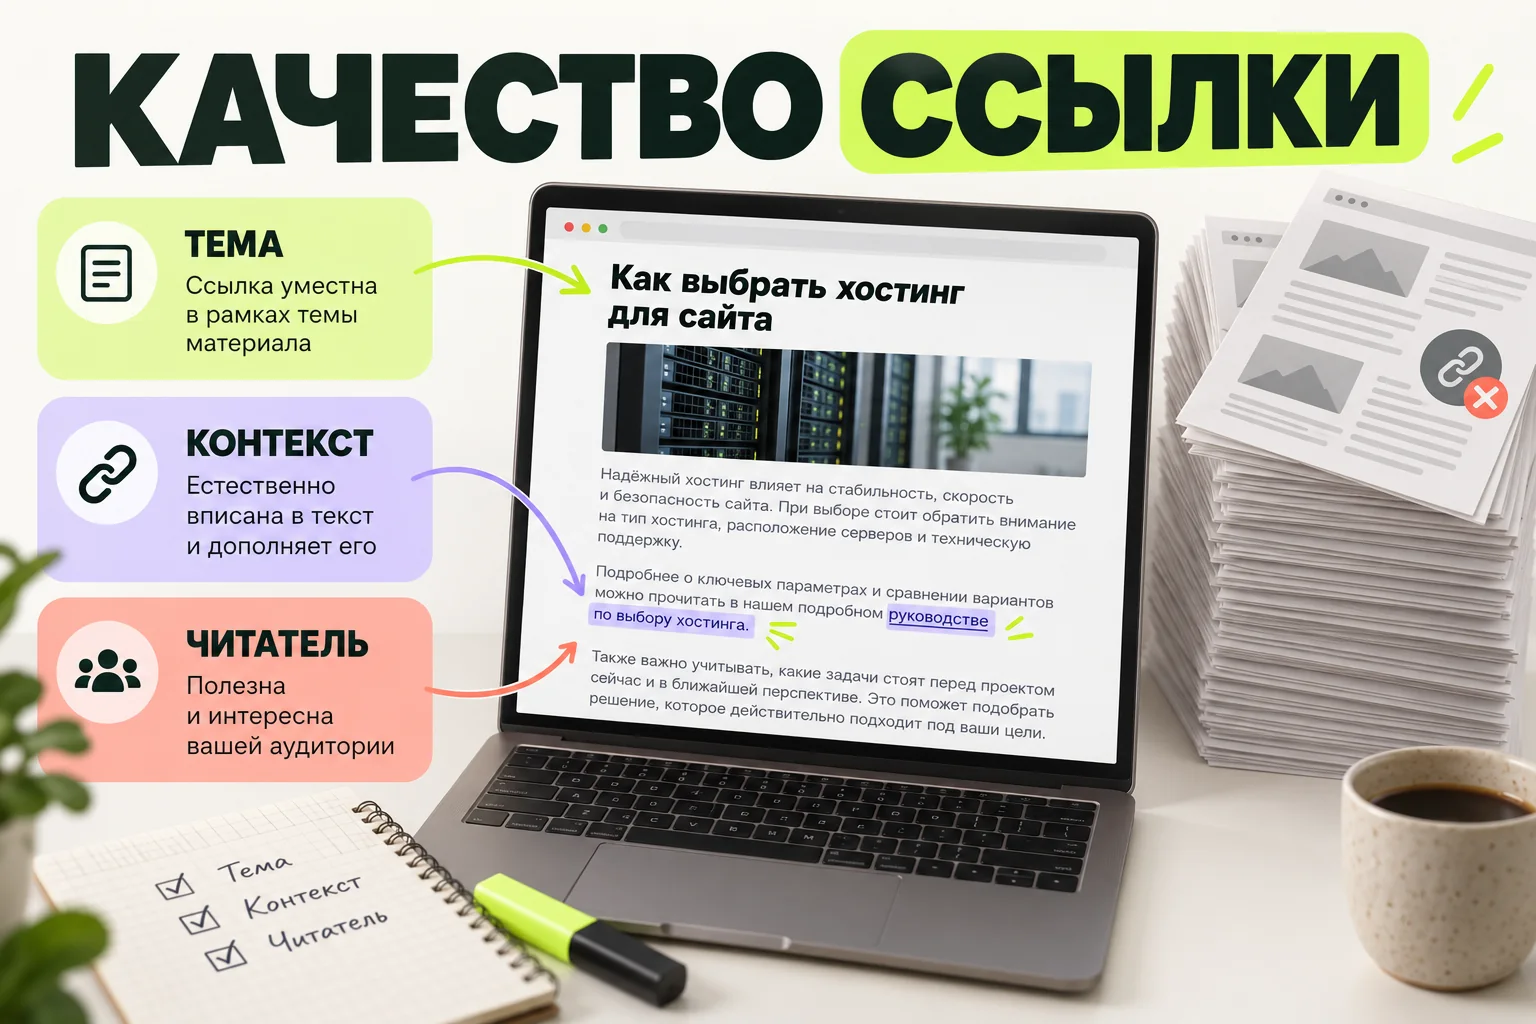
Входящая ссылка полезна читателю, когда помогает продолжить тему или проверить источник. Количество ссылок без контекста не показывает их ценность.
Что проверить
- Соберите доступный список входящих ссылок из кабинетов и сервисов. Укажите источник, дату и ограничения выгрузки.
- Откройте выборку страниц-доноров: тема, содержимое, место ссылки, анкор, адрес назначения, атрибуты rel и ответ сервера.
- Разделите редакционные упоминания, рекламу, пользовательские ссылки и очевидный мусор. Проверьте потерянные важные ссылки и переходы на удалённые страницы.
Если нашли проблему. Исправьте свои битые адреса и создавайте материалы, на которые есть смысл ссылаться. Для рекламных размещений используйте корректную маркировку ссылки, например rel=sponsored.
Готово, когда: Есть проверенные примеры и понятная оценка качества. Полнота профиля не заявлена, если доступна только выборка.
Важная деталь. Покупка ссылок ради манипулирования ранжированием нарушает правила Google. Не отправляйте disavow и не требуйте удаления всех незнакомых ссылок автоматически.
Официальная документация по этой проверке
Что исправлять первым
- Сайт недоступен или целиком закрыт от поиска. Сертификат, блокировка защиты, случайный noindex, общий запрет обхода. Здесь сначала восстанавливают доступ.
- Проблемы важных страниц. Ошибочный canonical, пустая отрисовка, битые переходы, неправильные ответы сервера. Начните со страниц услуг и входов из поиска.
- Шаблонные ошибки. Один исправленный шаблон может убрать одинаковую проблему на сотнях страниц. Проверьте результат на нескольких URL.
- Удобство и оформление. Скорость, мобильная форма, заголовки, картинки и превью. Их приоритет зависит от влияния на посетителя: сломанная форма важнее отсутствующего Open Graph.
- Повторная проверка. Подтвердите исправление в опубликованной версии и отдельно отслеживайте новый обход поисковика.
Дайте ИИ второе задание
«Возьми отчёт аудита. Предложи план исправлений для трёх самых важных проблем. Для каждой укажи затронутые файлы, риск, проверку результата и способ отката. Пока не меняй production».
Чтобы дополнить техническую проверку оценкой содержания, структуры и заявок, пройдите самостоятельный SEO-аудит сайта. Для работы с запросами начните с инструкций в разделе обучения.
Нужна помощь с исправлениями?
Пришлите отчёт и адрес сайта: разберём критичные находки и определим объём работ.
ОБСУДИТЬ SEO-АУДИТВопросы перед запуском
Помощник сам исправит сайт?
Этот скилл сначала проводит аудит и сохраняет отчёт. Изменения, отправка тестовых заявок и работа с production требуют отдельного задания. Так проще проверить выводы до вмешательства в сайт.
Нужно ли покупать Keys.so или другой сервис?
Для запуска скилла платные API не требуются. Сервисы могут дополнить данные о ссылках и поиске. Если их нет, помощник укажет доступные источники и ограничения, а не придумает полный ссылочный профиль.
Можно ли проверить сайт без исходников?
Да: HTTP-ответы, публичный HTML, ссылки и доступные страницы. Но причину в коде проекта, приватную настройку WAF и отчёты кабинетов без доступа подтвердить нельзя.
Все пункты зелёные. Когда будет топ?
Аудит не рассчитывает срок и не гарантирует место в выдаче. Он выявляет технические препятствия. Дальше важны спрос, содержание, конкуренция и полезность предложения.
Нужно проверять все 27 пунктов после каждой правки?
После небольшой правки проверьте затронутую часть. После запуска, переноса, смены шаблонов, домена или защиты нужен более широкий повторный аудит. В истории отчётов сохраняйте даты и выборку.